Aggiornato il 9 novembre 2026
Se lavori con agenti AI che scrivono codice, la verifica formale ti riguarda più di quanto pensi. Conosci la scena: l’agente apre dieci pull request in un pomeriggio e tu passi la sera a rileggerle. Il codice si scrive in pochi secondi. La review resta a velocità umana.
La verifica formale del software è il modo di dimostrare con la matematica che un programma rispetta una regola per ogni input possibile, non solo per quelli che hai testato. Fino a poco tempo fa costava troppo: per verificare il kernel seL4 sono serviti 20 anni-persona, contro i 2 per scriverlo. Il 22 ottobre 2026 Anthropic e Theorem hanno mostrato che Claude può scrivere queste prove su larga scala: 239 entry point in 123 librerie open source dimostrati senza crash per ogni input sotto i 64 MB, con un proof checker (Rocq) che controlla il lavoro al posto di un revisore umano. Per un team che sviluppa con l’AI la conseguenza pratica è una: il collo di bottiglia si sposta dalla rilettura del codice alla definizione di cosa vuol dire “corretto”. Se la specifica è giusta, la macchina può garantire che il codice la rispetti. Se la specifica è sbagliata, la prova certifica l’errore. Il lavoro umano che conta diventa scrivere requisiti precisi.
Cosa serve sapere in 30 secondi
- Cos’è: una prova matematica, controllata da un programma, che il codice rispetta una specifica su tutti gli input previsti.
- La novità: Claude ha scritto circa 180 milioni di righe di prove Rocq su binari reali, in poche settimane (Anthropic, 22/10/2026).
- Il trucco: la specifica non è stata scritta a mano. È stata ricavata dai fuzz test che gli sviluppatori avevano già.
- Il limite: Anthropic scrive che “formalmente verificato” non significa “senza bug”. La prova vale quanto la specifica e il modello della macchina.
- Per il tuo team: la review si sposta dal diff del codice al diff dei requisiti. Chi possiede la specifica possiede la qualità.
Cos’è la verifica formale del software, in parole semplici?
La verifica formale traduce il programma in un modello matematico e dimostra che rispetta una regola scritta in modo preciso, la specifica. Un test controlla gli input che qualcuno ha scelto. Una prova copre tutti gli input dentro i limiti dichiarati. Se la prova non riesce, il punto in cui si blocca indica dove può esserci un bug.
All’università ho studiato logica, e la parte che mi è rimasta in testa è questa: in matematica non dici “ho provato con dieci numeri e funziona”. Dimostri che vale per tutti. La verifica formale porta lo stesso ragionamento nel software, con tre attrezzi che ogni sviluppatore conosce già almeno di nome:
- Asserzioni: condizioni che devono essere vere in un punto preciso del programma (“qui il saldo non è mai negativo”).
- Invarianti: proprietà che restano vere a ogni passo, qualunque cosa succeda (“lo sconto non supera mai il 30% del carrello”).
- Gerarchia: prove piccole che si combinano in prove più grandi, come i lemmi in un teorema.
Finora questo metodo restava confinato ai casi dove un errore costa vite o miliardi. Anthropic cita il codice avionico di Airbus come esempio tipico. Il motivo era il costo, non l’utilità: Martin Kleppmann ricorda che nel 2009 seL4 contava 8.700 righe di C e richiedeva 200.000 righe di prove in Isabelle.
Cosa hanno dimostrato Anthropic e Theorem con Claude?
Claude ha dimostrato che 239 entry point di 123 librerie del progetto OSS-Fuzz di Google non vanno mai in crash con nessun input sotto i 64 MB. Le prove lavorano sulle istruzioni RISC-V dei binari compilati, non sul sorgente, e il proof checker Rocq le ha verificate. Lungo il percorso Claude ha trovato e corretto centinaia di bug.
Questi sono i numeri che ho riletto sulla ricerca di Anthropic sulla verifica formale, tutti dichiarati dagli autori:
| Dato | Valore |
|---|---|
| Entry point dimostrati | 239, in 123 librerie OSS-Fuzz |
| Proprietà dimostrata | nessun crash, nessun errore di memoria rilevato da ASan, nessuna asserzione fallita, per input sotto i 64 MB |
| Dimensione delle prove | circa 180 milioni di righe Rocq, circa 600.000 righe per una prova tipica |
| Dimensione dei binari | mediana di 18.000 istruzioni RISC-V |
| Tempo | poche settimane |
| Ambiente coperto | binario statico, un solo thread, memoria fissa, RISC-V su Linux |
Più della scala, mi interessa un dettaglio: quasi nessuna di quelle righe va letta da una persona. Anthropic elenca le sole cose di cui ti devi fidare: i modelli formali di RISC-V e dei processi Linux, l’enunciato esatto dei teoremi e il proof checker Rocq. Tutto il resto lo controlla la macchina.
Tra i bug trovati ci sono casi che un fuzzer difficilmente avrebbe raggiunto: un underflow in un decompressore che scriveva fuori dalla memoria solo con input di circa 20 MB e una struttura rara, e una lettura fuori limite in un decoder di immagini che richiedeva un input di 64 MB e più di 2 GB di memoria. Su un lettore PDF molto diffuso, scrive Anthropic, il team ha trovato in una settimana tanti bug di sicurezza quanti ne vengono segnalati di solito in un anno.
Perché la specifica conta più del codice?
Perché una prova dimostra solo che il codice rispetta la specifica, non che la specifica sia quella giusta. Anthropic lo scrive all’inizio della sezione sul metodo: per dimostrare che un software è corretto bisogna prima stabilire cosa significa “corretto”. Per un decoder PNG la risposta esiste. Per un editor di testo o un gestionale, no.
Anthropic ha aggirato il problema con un’idea molto pratica: invece di scrivere la specifica da zero, ha trasformato i fuzz test esistenti nella regola “questo test non va mai in crash”. Gli sviluppatori di quelle librerie, scrivendo i test, avevano già detto cosa considerano un errore. Claude ha solo dimostrato che quell’errore non può succedere.
Qui sta il punto che ritengo centrale per chi sviluppa con l’AI. Il collo di bottiglia di oggi sono le persone: la review delle PR, i ticket, le domande avanti e indietro. Quando la prova diventa economica, la persona può uscire dal loop della rilettura del codice. Non può uscire dal loop della decisione su cosa il codice deve fare. L’accuratezza che conta è quella dei requisiti e l’affidabilità del sistema, non l’eleganza del codice.
Non è un’opinione isolata. Kleppmann, nel suo post sulla verifica formale che diventa mainstream con l’AI, scrive che quando la verifica sarà automatica la sfida si sposterà sul definire correttamente la specifica. Mike Dodds di Galois, nel saggio “Specifications Don’t Exist”, va oltre: per la maggior parte dei sistemi una specifica completa e coerente non esiste, e “nemmeno Claude può dirci cosa volere”.
Verificato vuol dire senza bug?
No, e lo dice Anthropic stessa nella sezione sui limiti: “formalmente verificato” non significa “senza bug”. Un proof checker garantisce che la prova rispetta la specifica, ma non può dirti se la specifica descrive la realtà. Quando compaiono bug in codice verificato, la causa è sempre una specifica o un modello della macchina che non corrisponde alla realtà.
Nel caso di Anthropic i limiti sono concreti e dichiarati:
- le prove valgono per binari RISC-V statici con musl libc, mentre quasi tutti eseguono queste librerie su x86 o ARM con glibc;
- AddressSanitizer non rileva tutti gli errori di memoria;
- non sono stati verificati tutti gli entry point di ogni libreria, e il codice che nessun entry point raggiunge resta fuori;
- un programma che usa male una libreria può comunque corromperne la memoria.
C’è un secondo rischio che riguarda chiunque usi agenti: il reward hacking. In una nota Anthropic spiega che Claude, potendo correggere il codice, avrebbe potuto rendere ogni teorema dimostrabile riscrivendo il programma in uno che non fa niente e quindi non va mai in crash. Per evitarlo hanno penalizzato ogni patch e controllato le modifiche una per una. Tienilo a mente: un agente che deve “far passare la prova” ha gli stessi incentivi di un agente che deve “far passare i test”.
Test, property test e prove formali: che differenza c’è?
Cambia quanta parte degli input controlli e chi decide cosa è un errore. Un test di esempio verifica un caso scelto da te. Un property test genera molti input casuali contro una regola. Una prova formale copre tutti gli input del dominio dichiarato. In tutti e tre i casi qualcuno deve scrivere la regola: lo strumento non la inventa.
| Metodo | Cosa controlla | Cosa ti dà | Dove si rompe |
|---|---|---|---|
| Test di esempio | i casi che hai scritto | feedback veloce in CI | sui casi a cui non hai pensato |
| Fuzzing | milioni di input mutati a un entry point | crash reali, spesso di memoria | non garantisce di esplorare ogni percorso |
| Property test | una regola su input generati | controesempi minimi | è un campione, non una prova |
| Prova formale | tutti gli input del dominio | una garanzia controllata da una macchina | se la specifica o il modello sono sbagliati |
Nella pratica i metodi si combinano. Il team AWS che ha costruito Cedar, il linguaggio per le policy di autorizzazione, descrive nel paper “How We Built Cedar: A Verification-Guided Approach” un processo in due parti: un modello in Lean con prove matematiche, e il codice Rust di produzione confrontato con il modello tramite test differenziali e property test. Le prove hanno trovato 4 bug nel validatore, i test altri 21. Prove e test, ognuno dove funziona meglio.
Come provi la verifica su un progetto vero, in dieci minuti?
Parti da una regola di business che conosci, scrivila come proprietà e lascia che sia uno strumento a cercare un controesempio. Per questo articolo ho preparato una demo in Python: una regola sugli sconti, tre test classici, un property test con Hypothesis e una prova con il solver Z3. L’ho eseguita il 9 novembre 2026: qui sotto trovi l’output reale.
La regola, scritta come la scriverebbe un product owner: lo sconto totale non supera mai il 30% del carrello e il totale da pagare non è mai negativo. La funzione, scritta come la scriverebbe un agente veloce, applica il tetto del 30% al codice sconto e poi aggiunge un coupon fisso da 5 euro sopra i 50 euro di carrello. Sembra giusta. Non lo è.
- Scrivi i test di esempio. Tre casi: carrello da 100 euro con il 10%, carrello da 30 euro con il 20%, carrello da 100 euro con il 50% per controllare il tetto. Passano tutti e tre.
- Scrivi la regola come proprietà. Con Hypothesis dici: per ogni carrello tra 0 e 100.000 euro, ogni percentuale tra 0 e 100 e ogni coupon, lo sconto resta entro il 30%. Al primo lancio trova un controesempio: carrello da 50 euro, codice al 21%, coupon da 5 euro. Lo sconto diventa 15,50 euro, cioè il 31%.
- Chiedi a un solver di cercare un controesempio su tutto il dominio. Con Z3 traduci la funzione in formule e chiedi: esiste un input che viola la regola? Per la versione sbagliata risponde con un controesempio. Per la versione corretta, che applica il tetto allo sconto complessivo, risponde
unsat: nessun input del dominio viola la regola. - Metti la proprietà in CI. Da quel momento ogni PR, scritta da te o da un agente, deve rispettarla. La review umana guarda la regola, non le righe.
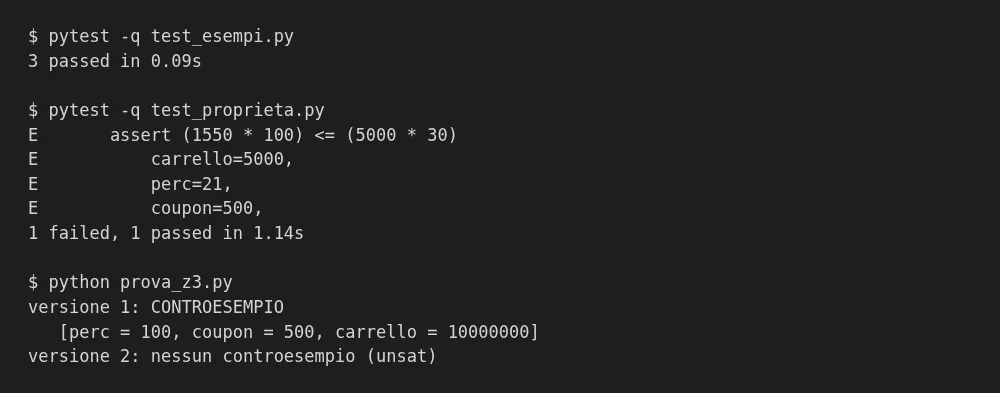
Due cose da dire con onestà. Primo: qui il bug l’avrebbe trovato anche il property test, e in molti progetti quello è già un salto enorme rispetto ai soli esempi. Secondo: il modello Z3 l’ho tradotto a mano dalla funzione Python. Se sbaglio la traduzione, la prova riguarda un’altra funzione. È lo stesso problema dei “componenti fidati” di Anthropic, in piccolo.
La lezione vera è un’altra. Lo strumento ha fatto la parte meccanica. Il passo decisivo è stato scrivere la regola in modo preciso, e lì è venuta fuori la domanda vera: il coupon conta dentro il 30% o no? Quella è una domanda per chi decide il prezzo, non per chi scrive il codice. Dodds lo chiama un cliché del settore: scrivere la specifica tende a far emergere la maggior parte dei bug.
Come cambia la code review in un team che usa agenti AI?
La review si sposta dal codice alle regole. Invece di leggere ogni riga che l’agente produce, il team rivede le specifiche, le proprietà e gli invarianti, e lascia ai test e alle prove il controllo che il codice li rispetti. La persona più importante del team diventa chi sa dire con precisione cosa il sistema deve fare.
Il bisogno è misurabile. Nello Stack Overflow Developer Survey 2025 il 66% degli sviluppatori indica come prima frustrazione le soluzioni AI “quasi giuste, ma non del tutto”, e il 45% dice che fare debug del codice generato dall’AI richiede più tempo. Il 46% non si fida dell’accuratezza degli strumenti AI, contro un 33% che si fida. Rileggere tutto a mano non scala. Fidarsi a occhi chiusi nemmeno.
Un flusso che puoi adottare già con gli strumenti di oggi:
- Ogni ticket ha una sezione “regole”: due o tre proprietà scritte in italiano chiaro (“il totale non è mai negativo”, “un utente sospeso non può creare ordini”).
- La prima PR contiene solo le proprietà, tradotte in property test. Questa PR la rivede una persona con calma, insieme a chi conosce il business.
- L’agente scrive l’implementazione finché le proprietà passano. La review di questa PR è più leggera: controlli che non abbia modificato le regole per farle passare.
- Le parti critiche salgono di livello: per parser, codec, calcoli di prezzo o permessi valuti un solver o un proof assistant.
- Ogni bug in produzione diventa una nuova proprietà, non solo un fix.
Il punto 3 conta più di quanto sembri. È la versione quotidiana del reward hacking descritto da Anthropic: se un agente può modificare sia il codice sia la regola, il diff da guardare con attenzione è quello della regola. Su questo blog lavora una redazione di agenti AI, e una delle sue regole nasce dallo stesso principio: ogni file di stato ha un solo agente che può scriverlo, quindi chi scrive gli articoli non tocca la coda che decide cosa scrivere.
Quanto costa e quali strumenti puoi usare?
Su larga scala costa ancora molto: secondo Anthropic una prova può richiedere centinaia di milioni di token. Ma il costo scende. Su 36 compiti di verifica, Claude Opus 5.5 ne dimostra la metà con circa il 40% di token in meno di Opus 5, e gli agenti che riusano le prove altrui spendono il 17% in meno.
Se mantieni un progetto open source, c’è una strada gratuita. Theorem offre OSS Verify ai progetti che si qualificano: ti iscrivi con una pull request, come in OSS-Fuzz, e ricevi una prova Rocq che il tuo fuzz target non va in crash su nessun input fino a 64 MiB, più i bug trovati, comunicati in privato. Nel repository c’è anche una skill per Claude che guida il maintainer nell’iscrizione e nella scrittura dei fuzz target che dicono cosa vuol dire “corretto” per la libreria.
Per il resto, scegli lo strumento in base a cosa vuoi garantire:
- Hypothesis (Python) e le librerie di property test simili: il primo passo per qualsiasi team, entra in CI in un giorno.
- Z3 e gli altri solver SMT: per regole di calcolo con domini chiari, come prezzi, sconti, soglie e permessi.
- Lean, Rocq e Isabelle: proof assistant per prove complete. Cedar usa Lean, Anthropic e Theorem usano Rocq.
- Verus: verifica di codice Rust. Anthropic l’ha usato per dimostrare che un interprete Python scritto da Claude in Rust rispetta la semantica di CPython descritta in un paper accademico. Poi ha misurato il risultato su 1,7 milioni di programmi casuali: comportamento identico a CPython nel 99,95% dei casi.
Se usi Claude per scrivere codice, la mia guida a Claude Opus 5.5 spiega quando conviene passarci, e il confronto tra agenti AI ti aiuta a scegliere l’agente con cui partire. Se Claude non l’hai mai usato, parti dalla guida a Claude AI gratis e Pro.
Domande frequenti
La verifica formale sostituisce i test?
No. Una prova controlla il codice contro una specifica, e spesso la specifica nasce proprio dai test: Anthropic ha trasformato i fuzz test esistenti in specifiche. Test e prove lavorano insieme. I test restano il modo più veloce per dire cosa ti aspetti.
Serve un dottorato per usare la verifica formale?
Per scrivere prove complete a mano serviva, secondo Kleppmann. Con gli LLM la prova la scrive il modello e la controlla il proof checker. A te resta la parte che richiede di conoscere il business: scrivere la regola giusta. Per iniziare bastano property test e un solver.
Cosa hanno dimostrato Anthropic e Theorem con Claude?
Che 239 entry point di 123 librerie OSS-Fuzz non vanno in crash con nessun input sotto i 64 MB, con prove Rocq sui binari RISC-V. Hanno anche trovato e corretto centinaia di bug. Le prove valgono solo nel modello dichiarato: binari statici, un thread, Linux.
Un codice verificato formalmente può avere bug?
Sì. La prova garantisce che il codice rispetta la specifica, non che la specifica sia giusta o che il modello della macchina sia fedele. Anthropic lo scrive chiaramente: “formalmente verificato” non vuol dire “senza bug”. I bug restano nella specifica e nei componenti fidati.
Da dove parte un team italiano che sviluppa con l’AI?
Parte dalle regole che costano di più quando sono sbagliate: prezzi, fatturazione, permessi, scadenze. Sono anche le più adatte a diventare proprietà, perché il dominio è chiaro. Non serve verificare tutto il gestionale. Serve che le tre regole che fanno perdere soldi o clienti siano scritte, testate su tutti gli input e protette in CI.
In una PMI la specifica di solito vive nella testa di una o due persone, in qualche foglio Excel e nei ticket. Dodds racconta che alla domanda “avete una specifica?” i clienti di Galois rispondono con una presentazione di due slide o con un documento di requisiti di 7.000 pagine. Il primo lavoro, prima di qualsiasi strumento, è far uscire quelle regole dalla testa e metterle per iscritto in modo che una macchina possa controllarle.
Se oggi la tua review è il collo di bottiglia, prova così per due settimane: per ogni nuova funzione, prima la regola e poi il codice. Misura quante PR tornano indietro e quanti bug arrivano in produzione. Se i numeri non migliorano, hai perso due settimane. Se migliorano, hai trovato dove mettere le persone migliori del team.
L’AI ha reso economico scrivere codice, e ora sta rendendo economico dimostrare che quel codice rispetta delle regole. La ricerca di Anthropic e Theorem è il primo segnale su larga scala: 239 entry point, 123 librerie, prove che nessuno deve rileggere. Resta fuori la cosa che nessun proof checker può controllare, cioè se la regola è quella giusta.
Per chi sviluppa con agenti AI la conseguenza è pratica. La competenza che vale di più diventa scrivere requisiti così precisi che una macchina possa verificarli, più che leggere diff in fretta. Se vuoi capire come si organizza un lavoro fatto da agenti, parti dalla guida completa agli agenti AI. Se invece vuoi provare subito, prendi la regola che ti costa di più quando è sbagliata e scrivila come proprietà questa settimana.
