Aggiornato il 23 settembre 2026
Claude Opus 5.5 è il primo modello della famiglia Claude 5.5, lanciato da Anthropic il 22 settembre 2026. Sul lavoro tipico Anthropic lo mette al livello di Claude Fable 5.1, con un costo tipico circa −40% rispetto a Opus 5. Listino API verificato oggi: input $4 / MTok, output $20 / MTok, cache read $0,20 / MTok. Output più veloce di oltre 30% vs Opus 5. Su Chat, Cowork e Claude Code è già disponibile (API id claude-opus-5-5). Un esempio concreto di cosa ci si costruisce: MailCheap, il tool per newsletter self-hosted su Amazon SES che Marc Lou dice di aver scritto in vibe coding con Opus 5.5.
Per un marketer italiano la domanda non è “cos’è Opus 5.5”. È: sposto il default da Fable 5.1 Medium (o da Opus 5) a Opus 5.5 su copy, slide, research e brief? Questa pagina è il playbook di switch. Non è un pezzo sul coding / CursorBench e non ripete la guida Claude Fable 5.1. Il confronto stack più ampio resta su Claude Opus 5 vs GPT-5.6 Sol. Fonti vendor verificate oggi: post Anthropic Opus 5.5 e pricing docs.
Cosa serve sapere in 30 secondi
- Claude Opus 5.5 è GA dal 22/09/2026; API id
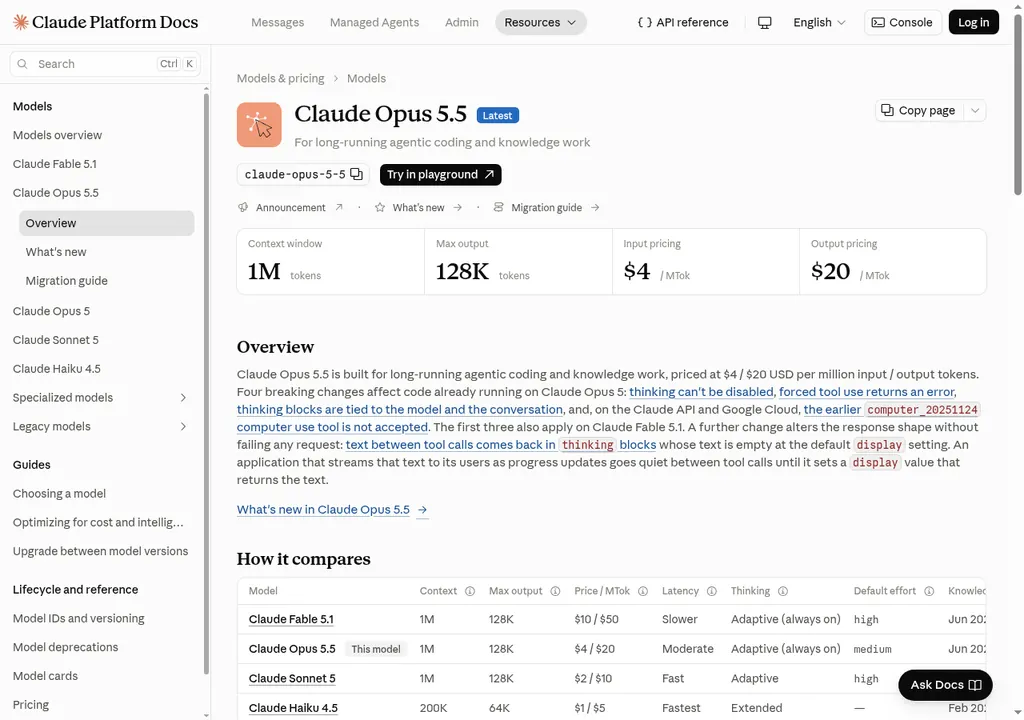
claude-opus-5-5; contesto 1M, output max 128K; knowledge cutoff giugno 2026 (overview docs). - Prezzi API oggi: $4 input / $20 output / cache read $0,20 / MTok. Opus 5: $5 / $25 / $0,50. Fable 5.1: $10 / $50 / $0,25 (pricing).
- Anthropic: su carichi tipici costa circa −40% vs Opus 5; genera output >30% più veloce; default effort medium (Opus 5 partiva da high).
- Communication: scrittura più chiara e naturale vs Opus 5 — rilevante per brief, slide e copy marketing.
- AutomationBench (Zapier, post ufficiale): Opus 5.5 40,0%; Fable 5.1 31,4%; Opus 5 26,9%; GPT-6 Astra 41,4%.
- GDPval-AA v2.1: Opus 5.5 1846 Elo vs Fable 1735 e Opus 5 1708 (stesso post).
- Default mio (vendor + picker Chat first-hand Victor 23/09, Opus 5.5 + Effort Medium): Opus 5.5 per la maggior parte di copy/slide/research; Fable 5.1 solo se le tue eval sul task lungo restano superiori. Screenshot di un run marketing completo: waivato dall’autore per questo publish.
Cos’è Claude Opus 5.5 e cosa cambia per il marketing?
Claude Opus 5.5 è il modello Anthropic per coding agentico, computer use e knowledge work: research, analisi, documenti, fogli e presentazioni. Anthropic lo posiziona al livello di Fable 5.1 sulla maggior parte del lavoro, con listino e token-per-task più bassi di Opus 5.
Per te, in redazione o in agenzia, cambiano tre cose concrete:
- Costo tipico. −40% vs Opus 5 sui carichi dichiarati da Anthropic, più token in meno per task. Su API e su sessioni lunghe in Chat/Cowork conta.
- Voce e struttura. Il post ufficiale insiste sulla comunicazione più naturale: info importanti in testa, meno jargon, slide più dense (feedback early tester finance/consulting).
- Effort default medium. Su Opus 5.5 parti da medium; Anthropic dice che a medium spesso eguaglia o batte Opus 5 a high su coding e knowledge-work. Calibra sulle tue eval, non sulle etichette.
Cosa NON è questa guida:
- Non è una recensione CursorBench / Terminal-Bench per developer.
- Non è un altro “cos’è Fable 5.1” — quello sta già live.
- Non inventa score AutomationBench o prezzi: solo numeri dal vendor al 23/09/2026.
Quanto costa Claude Opus 5.5 rispetto a Opus 5 e Fable 5.1?
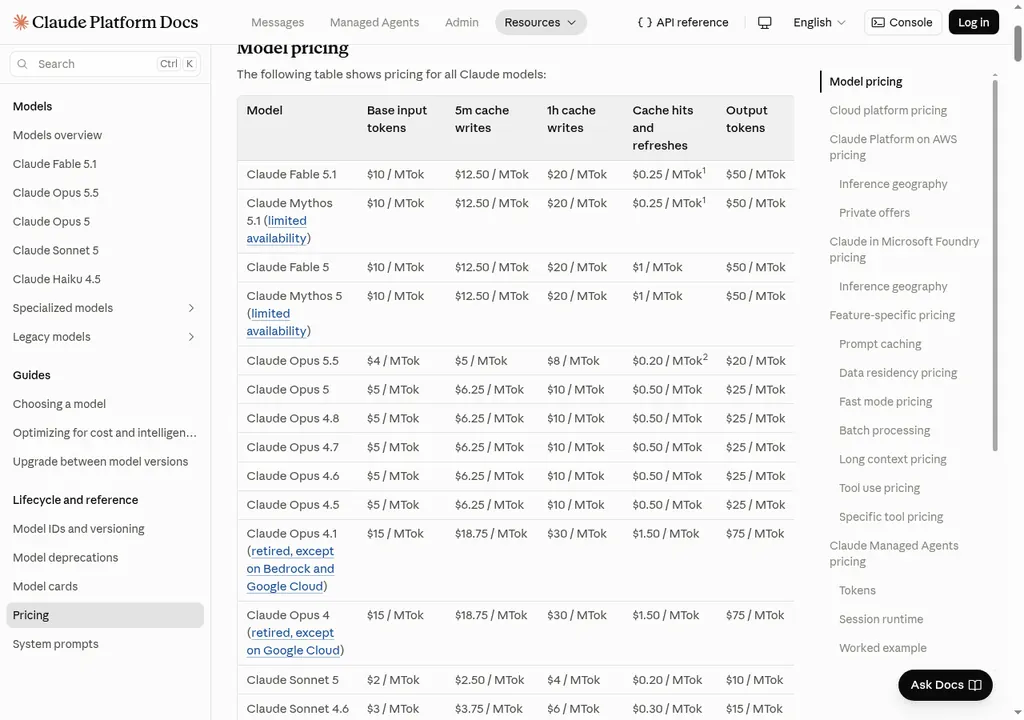
Al 23 settembre 2026, sul listino Claude Platform / docs Anthropic, Opus 5.5 costa $4 input e $20 output per milione di token. Opus 5 resta a $5 / $25. Fable 5.1 resta a $10 / $50. La cache read di Opus 5.5 è $0,20 (0,05× il base input); su Opus 5 è $0,50; su Fable 5.1 è $0,25.
Tabella verificata oggi su docs pricing:
| Modello | Input / MTok | Output / MTok | Cache write 5m | Cache write 1h | Cache read |
|---|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $5 | $8 | $0,20 |
| Claude Opus 5 | $5 | $25 | $6,25 | $10 | $0,50 |
| Claude Fable 5.1 | $10 | $50 | $12,50 | $20 | $0,25 |
| Claude Sonnet 5 | $2 | $10 | $2,50 | $4 | $0,20 |
Altri pezzi del listino utili in redazione:
- Fast mode (research preview, solo Claude API first-party): Opus 5.5 a $8 / $40, fino a circa 2,5× più veloce (post + pricing).
- Batch API: Opus 5.5 a $2 / $10 (50% off).
- Anthropic aumenta i limiti a 5 ore su Pro, Max, Team e Enterprise seat-based e offre un rate-limit reset salvabile.
Come leggerla da marketer, senza inventare volumi italiani:
- Copy corta / email / meta su API: Opus 5.5 batte Opus 5 sul listino (−20% input/output base) e sul tipico (−40% dichiarato). Non ha senso restare su Opus 5 “per abitudine”.
- Slide pack + research multi-fonte: il vantaggio non è solo il prezzo token; Anthropic cita meno token per task e scrittura più facile da revisionare.
- Fable 5.1 resta il doppio (o più) di Opus 5.5 sul base rate. Lo tieni se le tue eval sul task lunghissimo lo richiedono, non perché “è il modello più caro”.
Quando passare a Opus 5.5 e quando restare su Fable 5.1 Medium?
Passa a Opus 5.5 come default su Chat/Cowork per copy, brief, deck, research knowledge-work e report che prima giravi su Opus 5 — o su Fable quando Fable era solo “il più forte disponibile”. Resta su Fable 5.1 Medium se le tue eval su orchestrazione multi-ora / multi-tool restano superiori, o se hai già un flusso Max calibrato su Fable che non vuoi rompere al giorno 1.
Regola operativa che userò io (e che puoi copiare):
| Lavoro marketing | Default post-22/09 | Perché |
|---|---|---|
| Headline, meta, CTA, email one-shot | Opus 5.5 | Listino più basso di Opus 5; writing più chiaro |
| Landing / sales page da rivedere | Opus 5.5 → tu in chiusura | Bozza più leggibile; tu firmi la voce brand |
| Research competitor multi-fonte | Opus 5.5 (medium) | Knowledge work + GDPval in testa al post ufficiale |
| Deck 10–20 slide da brief | Opus 5.5 | Early tester: slide più dense, meno verbose |
| Agent loop / Cowork multi-ora su stesso contesto | Fable 5.1 se le tue eval lo dicono; altrimenti prova Opus 5.5 | Anthropic: gap Fable↔Opus 5.5 più stretto dei benchmark |
| Cyber / biology dual-use | fallback / programmi verified | Safeguard simili a Fable 5.1 sul lancio |
Tre segnali che stai sbagliando modello:
- Tieni Opus 5 “perché funzionava”: sul listino e sul tipico Opus 5.5 lo batte.
- Usi Fable 5.1 per ogni subject line: bruci limiti Max / crediti Pro senza bisogno.
- Migri tutto il team il giorno del lancio senza un brief pilota: non sai ancora dove Opus 5.5 fallisce sulla tua brand voice.
Il pezzo sul default Fable Medium in Cowork resta valido come contesto storico; dopo il 22/09 il candidato default per la maggior parte del lavoro marketer diventa Opus 5.5. Dettaglio Fable: Claude Fable 5.1 per marketer.
Dal 28/09/2026 per headline, meta description e slide da template c’è anche un’alternativa a metà prezzo: ecco quando usare Claude Sonnet 5.5 al posto di Opus 5.5.
Il rivale diretto di Opus 5.5 a listino pieno è Gemini 4 Argon ($4/$20 dopo il prezzo di lancio), annunciato il 30/09/2026 ma non ancora aperto: qui trovi quando prepararti a Gemini 4 Argon.
Copy, slide e research: cosa dice Anthropic (e cosa no)
Anthropic non pubblica un “+X% conversioni newsletter italiane”. Pubblica miglioramenti su scrittura, knowledge work e workflow business. Quelli, al 23/09/2026, sono i pezzi citabili.
Cosa puoi usare in un brief interno senza inventare numeri:
- Writing. Side-by-side nel post ufficiale: Opus 5.5 mette il punto in testa, riduce jargon, segue meglio le regole di scrittura. Early tester (Ramp, Stripe, Box): output più facile da seguire, meno verbose.
- Slide / presentation. Esempio interno merger HR software: stesso conclusioni di Opus 5, presentazione più leggibile, 63 minuti vs 93, costo circa −50% sul task (post Anthropic).
- Research. Report trimestrale su web “difficile”: 16/18 report Opus 5.5 passano il grader anti-invenzione; Fable 5.1 e Opus 5 zero in quel test (stesso post).
- AutomationBench. 40,0% (Zapier early access, senza fallback: i safeguard contano come fail). Utile per workflow multi-app; non è un KPI Meta Ads.
Cosa non promettere al cliente:
- “Opus 5.5 alza il ROAS”.
- “AutomationBench 40% = +40% produttività team”.
- Qualsiasi prezzo Pro/Max mensile inventato: qui cito solo API e claim tipico −40%.
Se ti serve il quadro modelli più largo (ChatGPT, Gemini, Claude), parti dalla guida completa all’intelligenza artificiale.
Opus 5.5 vs Fable 5.1 vs Opus 5: tabella decisionale
Ecco il confronto che uso io per scegliere il modello in coda marketing, con numeri solo dal vendor al 23/09/2026.
| Criterio | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Input / output / cache read | $4 / $20 / $0,20 | $10 / $50 / $0,25 | $5 / $25 / $0,50 |
| Claim costo tipico vs Opus 5 | −40% | n/d (listino più alto) | baseline |
| Default effort (docs) | medium | high | high |
| AutomationBench | 40,0% | 31,4% | 26,9% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 |
| Writing / clarity (vendor) | salto dichiarato vs Opus 5 | forte su agentic lungo | più verboso (feedback post) |
| Disponibilità Chat/Cowork/Code | sì (post 22/09) | sì | sì |
| Uso marketer default | sì, nuovo default | task lunghissimi se eval ok | legacy; migrare |
Nota Anthropic da non saltare: a questi livelli di capability, i margini di benchmark sono meno affidabili delle differenze reali. Loro stessi dicono che il gap Opus 5.5 ↔ Fable 5.1 è più stretto di quanto suggeriscano gli score. Per questo la decisione resta sulle tue eval su brief e deck, non sul leaderboard.
L’ho verificato oggi: picker Opus 5.5 first-hand
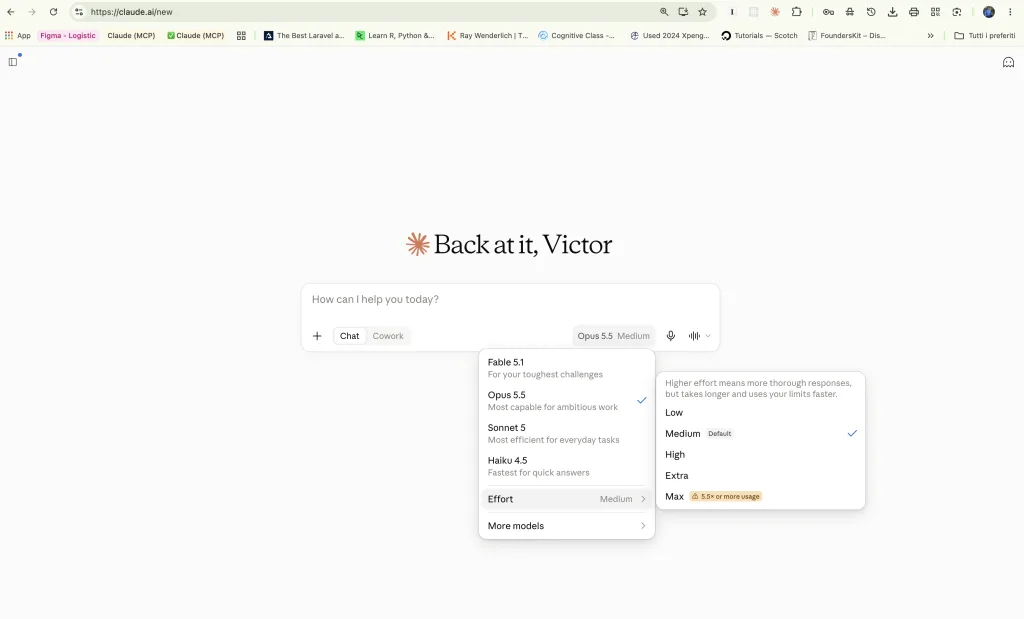
Oggi, 23 settembre 2026, ho riaperto le fonti vendor e — con sessione autenticata di Victor — il model picker di Claude Chat. Opus 5.5 è selezionabile in Chat: greeting «Back at it, Victor», URL claude.ai/new, modello Opus 5.5 spuntato, Effort Medium (default). Lo screenshot del picker è first-hand di Victor (23/09). Lo screenshot di un run marketing completo (brief/slide/research in Chat o Cowork) è waivato dall’autore per questo publish: «Pubblica senza l’ultimo screenshot di run reale».
Cosa ho verificato oggi:
- Picker Claude Chat — Opus 5.5 selezionato, Effort Medium, account Victor (shot first-hand 23/09).
- Post Anthropic Opus 5.5 — claim −40%, prezzi $4/$20, cache $0,20, tabella benchmark, disponibilità Chat+Cowork+Code.
- Docs pricing — riga Opus 5.5 allineata al post; Fable e Opus 5 confermati.
- Docs overview Opus 5.5 — API pricing, default effort medium, cutoff giugno 2026.
Cosa resta fuori (waivato per il publish, non inventato):
- Screenshot di un brief/slide/research lanciato end-to-end in Chat o Cowork.
- Misura burn crediti / limiti settimanali sul piano Pro/Max in un run lungo.
Numeri vendor e disponibilità picker sono solidi; il playbook decisionale tiene. Il gate prodotto passa sul picker first-hand + waiver esplicito sul run.
Come lo metti in coda marketing questa settimana
Parti da un solo flusso pilota su Opus 5.5, misura qualità voce e costo, poi allarga. Non migrare tutta l’agenzia il giorno dopo il lancio.
Checklist in cinque passi:
- Picker. Su Pro/Max, verifica che Opus 5.5 compaia in Chat e in Cowork. Imposta effort medium come partenza.
- Brief pilota unico. Stesso input che usavi su Opus 5 o Fable: research competitor + outline 12 slide, oppure un brief campagna completo.
- Confronto side-by-side. Stesso prompt su Fable 5.1 Medium (se ancora nel picker). Giudica densità slide, invenzioni, voce — non il leaderboard.
- Chiusura umana. Headline, meta e CTA le firmi tu. Opus 5.5 accelera la bozza; non sostituisce il brand check.
- API / caching. Se sei su Platform, attiva prompt caching e guarda la quota cache read a $0,20. Fast mode solo se aspetti ogni reply e accetti $8/$40.
Stack correlato sulla redazione: Claude Cowork per il desktop agent, Claude Skills per i pezzi ripetibili, agenti AI marketing per il quadro agent.
Domande frequenti su Claude Opus 5.5
Claude Opus 5.5 cos’è e in cosa migliora rispetto a Opus 5?
È il primo modello della famiglia Claude 5.5 (lancio 22/09/2026). Anthropic dichiara livello vicino a Fable 5.1 sul lavoro tipico, tipico −40% vs Opus 5, output >30% più veloce, writing più chiaro. Listino API: $4/$20 vs $5/$25 di Opus 5.
Conviene passare da Claude Fable 5.1 a Opus 5.5 per brief e deck?
Nella maggior parte dei casi sì come default: costo base molto più basso e claim di writing/slide migliori vs Opus 5. Resta su Fable se le tue eval su orchestrazione lunghissima restano superiori. Anthropic stesso dice che il gap reale è più stretto dei benchmark.
Quanto costa Claude Opus 5.5 in API rispetto a Opus 5?
Al 23/09/2026: Opus 5.5 a $4 input / $20 output / $0,20 cache read per MTok; Opus 5 a $5 / $25 / $0,50. Fast mode Opus 5.5: $8 / $40. Batch: $2 / $10. Fonte: docs pricing Anthropic.
Opus 5.5 scrive meglio di Opus 5 per copy e slide marketing?
Secondo Anthropic e gli early tester citati nel post ufficiale, sì sulla chiarezza e sulla densità delle slide. Non esiste un A/B pubblico su conversioni italiane. Usa un brief pilota sulla tua brand voice prima di migrare tutto.
Su Cowork/Chat conviene default Opus 5.5 o restare su Fable Medium?
Default consigliato post-lancio: Opus 5.5 a effort medium. Fable 5.1 Medium resta l’opzione se il task è lunghissimo e le tue eval lo preferiscono. Sul piano di Victor, al 23/09, Opus 5.5 compare già nel picker Chat (shot first-hand).
Conclusione
Claude Opus 5.5, al 23 settembre 2026, è il candidato default per copy, slide, research e brief su Claude Chat/Cowork: $4 / $20, tipico −40% vs Opus 5, scrittura più chiara sul claim vendor. Fable 5.1 non sparisce: resta per i task dove le tue eval lo tengono sopra. Opus 5 diventa legacy sul listino.
Questa run ha verificato post, pricing e — first-hand — il picker Chat con Opus 5.5 + Effort Medium (shot Victor 23/09). Lo screenshot del run marketing completo è waivato dall’autore per il publish.
Contesto prodotto: Fable 5.1, Opus vs Sol per il marketing, guida AI. Fonti primarie: Anthropic — Opus 5.5 e pricing docs.
Autore: Victor Motricala — consulente marketing e AI. Scrivo playbook operativi per marketer italiani su victormotricala.it.
