Aggiornato il 10 novembre 2026
Claude Fable 5.2 è uscito il 9 novembre 2026 e sostituisce Fable 5.1 come modello di punta per il lavoro lungo: genera output fino al 30% più veloce, blocca circa il 55% di richieste in meno e costa meno via API, $8 input / $40 output per milione di token contro $10 / $50 della 5.1. Resta il doppio di Opus 5.5 ($4 / $20), che Anthropic indica ancora come modello da cui partire. Se hai il piano Pro, fino al 16 novembre Fable è incluso nei limiti fino al 50% della quota settimanale. Fonti lette oggi: annuncio Anthropic Fable 5.2, Help Center, offerte di lancio e listino API.
Se già usi Claude Cowork, Claude Skills o agenti AI per il marketing, questa pagina ti dice quando Fable vale i limiti che consuma. Non parla di coding Mythos né di IPO. La parte su Fable 5.1 (settembre 2026) resta più sotto, con i numeri di allora.
Cosa serve sapere in 30 secondi
- Claude Fable 5.2 è disponibile da 09/11/2026 per Pro, Max, Ultra, Team ed Enterprise; API id
claude-fable-5-2; contesto 1M token, output max 128K (docs Anthropic in italiano). - Prezzi API letti oggi: input $8, output $40, cache read $0,20 / MTok; fast mode (fino a 2,5× più veloce) $16 / $80. Opus 5.5: $4 / $20, cache read sempre $0,20.
- Piano Pro: dal 09/11 al 16/11/2026 (23:59 ora del Pacifico, cioè le 08:59 del 17/11 in Italia) Fable rientra nei limiti fino al 50% della quota settimanale, più un reset Fable. Poi torna a usage credits.
- Max e Ultra: Fable resta incluso fino al 50% dei limiti settimanali, più da 1 a 3 reset in base all’anzianità, validi fino all’8 marzo 2027.
- Benchmark business del post ufficiale: AutomationBench 51,4% (Opus 5.5 42,5%, Fable 5.1 31,4%); lettura grafici Chartography 73,4% (Opus 5.5 64,4%).
- Default mio da oggi: Opus 5.5 per headline, landing, email; Fable 5.2 a Medium per research multi-fonte, report da dati e grafici, deck e agent loop in Cowork.
Cosa cambia in Claude Fable 5.2 rispetto a Fable 5.1?
Fable 5.2 è lo stesso tipo di modello della 5.1, ma più veloce (fino al 30%), più economico via API (−20% su input e output) e più forte sul lavoro d’ufficio: AutomationBench passa da 31,4% a 51,4%, Chartography da 44,8% a 73,4%. Blocca meno richieste per errore (circa −55%). Contesto e output massimo restano 1M e 128K token.
Il confronto con i numeri ufficiali, tutti letti il 10/11/2026 sul post Anthropic e sul listino (effort più alto disponibile, safeguard attivi):
| Voce | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| Prezzo API input / output (MTok) | $8 / $40 | $10 / $50 | $4 / $20 |
| Cache read (MTok) | $0,20 | $0,25 | $0,20 |
| AutomationBench (workflow business) | 51,4% | 31,4% | 42,5% |
| Chartography (lettura grafici, senza tool) | 73,4% | 44,8% | 64,4% |
| AA-Briefcase v1.1 (knowledge work), rubric | 66,1% | 61,5% | 61,2% |
| AA-Briefcase v1.1, Elo | 1785 | 1669 | 1800 |
| Remote Labor Index | 41,3% | 17,9% | 21,3% |
| WANDR (ricerca agentica, relaxed) | 82,1% | 68,7% | 72,3% |
Tre cose che la tabella non dice da sola:
- Effort predefinito: nelle app Claude e in Claude Code parte a Medium; sull’API a High. Sulla 5.1 Claude Code partiva a High.
- Meno blocchi: Anthropic misura circa il 55% di blocchi in meno rispetto alla 5.1 su claude.ai, Claude Code e Cowork. Se una richiesta viene bloccata, risponde Opus 4.8 (cyber) o Opus 5 (biologia).
- Chi usa l’API: ci sono quattro modifiche che possono rompere il codice scritto per la 5.1 (controllo del prefisso, blocchi di ragionamento, vecchio tool computer use, advisor). Se Cowork o claude.ai costruiscono le richieste per te, non cambia nulla.
Sul knowledge work puro il quadro è misto: Fable 5.2 vince sulla rubric di AA-Briefcase ma perde di poco sull’Elo contro Opus 5.5 (1785 contro 1800). Su AutomationBench, poi, Gemini 4 Carbon segna 53,9%, sopra Fable. Per un marketer il salto vero è su report con grafici e ricerche lunghe, non sulla frase da pubblicare.
Come provi Fable 5.2 sul piano Pro entro il 16 novembre?
Con il piano Pro, fino al 16 novembre alle 23:59 del Pacifico (08:59 del 17/11 in Italia) Fable 5.2 usa i limiti del piano invece degli usage credits, fino al 50% della quota settimanale. Se pagavi già prima del 9 novembre alle 19:00 (ora italiana) hai anche un reset Fable, che scade con la settimana.
Chi riceve cosa, secondo l’articolo del Help Center letto oggi:
| Piano | Offerta di lancio | Scadenza |
|---|---|---|
| Free | Niente, Fable non c’è | — |
| Pro, Team posto standard | Fable incluso fino al 50% dei limiti settimanali + 1 reset Fable | 16/11/2026, 23:59 PT |
| Max, Ultra, Team posto premium | Da 1 a 3 reset Fable (meno di 6 mesi: 1; 6–12 mesi: 2; oltre 12 mesi: 3) | 08/03/2027, 23:59 PT |
Come lo usi senza sprecare la settimana:
- Apri claude.ai o Cowork e scegli Fable 5.2 nel selettore modelli. Lascia Medium.
- Controlla il consumo in Impostazioni → Utilizzo: Fable brucia i limiti più in fretta degli altri modelli.
- Usa il reset solo quando hai finito la quota Fable: in Limit resets premi «Reset for free». Ti restituisce l’uso speso su Fable, non quello su Opus o Sonnet, e non alza i limiti.
- Dopo il 16/11, se non hai attivato gli usage credits, su Pro Fable si ferma.
Tre lavori marketing che io proverei questa settimana, uno per giorno: un report mensile da export di Google Analytics o Search Console con grafici da leggere, una ricerca su 10 o più concorrenti con tabella finale, un deck cliente da un brief lungo. Sono i casi dove i benchmark di Fable 5.2 staccano Opus 5.5. Per email e post social non sprecare la quota.
Cos’è Claude Fable 5.2 e per chi è pensato?
Claude Fable 5.2 è il modello Anthropic per il ragionamento impegnativo e il lavoro agentico lungo: research a più passaggi, documenti, fogli, slide, analisi di dati. È lo stesso modello di Mythos 5.2, ma con safeguard su cyber e biologia che lo rendono disponibile a tutti. Per la maggior parte dei task Anthropic dice di partire da Opus 5.5 e salire a Fable quando non basta.
In pratica, se gestisci una coda marketing (brief, research competitor, deck, report settimanale), Fable 5.2 è il pezzo “orchestratore”: tiene il contesto, chiama tool, delega i compiti semplici a modelli più piccoli e rivede il proprio output. Non è il sostituto automatico di Opus sulla frase da pubblicare.
E Claude Mythos 5.2? È lo stesso motore senza alcuni safeguard su cybersecurity e biologia. Non lo attivi dal piano: lo ottengono solo organizzazioni verificate tramite il Cyber Verification Program o il Life Sciences Verification Program. Le aziende Enterprise lo vedono dentro Claude Security per la scansione del codice. Per un marketer non cambia nulla: il modello che puoi usare è Fable.
Cosa NON è, per questa pagina:
- Non è Mythos / Project Glasswing (accesso verificato, cyber e life sciences).
- Non è un pezzo sul coding agent in Claude Code.
- Non è un confronto IPO o di mercato.
La scheda docs di Fable 5.2 (letta il 10/11/2026) lo riassume così: for demanding reasoning and long-horizon agentic work, con il consiglio esplicito di partire dal modello Opus più recente.
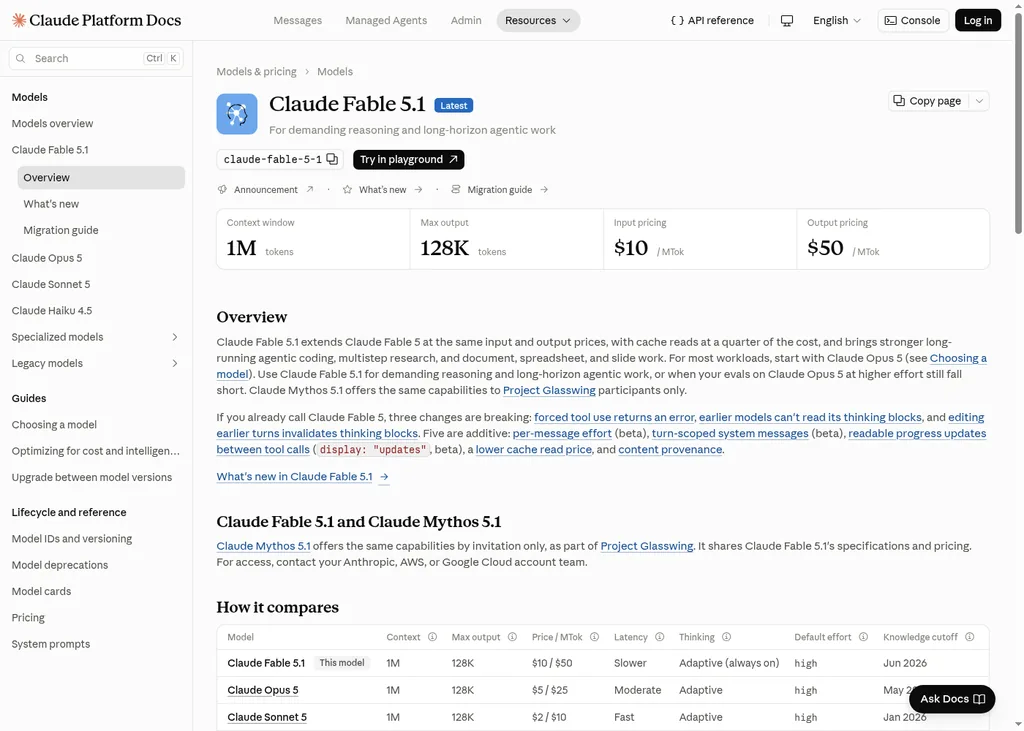
claude-fable-5-1, 1M / 128K, $10 / $50. Fable 5.2 ha gli stessi 1M / 128K a $8 / $40.Cosa cambia in Claude Cowork con default Medium?
In Claude Cowork, su claude.ai e (con la 5.2) anche in Claude Code, Fable parte a effort Medium. Sull’API il default resta High. Secondo Anthropic, a Medium Fable 5.2 chiude task difficili con meno token della 5.1; High e oltre alzano qualità e spesa sui task più duri.
Per te, su brief lunghi / research / slide, significa tre cose concrete:
- Meno consumo di limiti sul piano Pro/Max rispetto a lasciare High di default su ogni sessione Cowork.
- Sessioni più lunghe prima di battere i limiti settimanali: su Max e Ultra Fable usa fino al 50% dei limiti settimanali (pagina prezzi Claude, 10/11/2026); su Pro gira a usage credits, tranne la settimana di lancio fino al 16/11.
- Qualità “abbastanza” per research e deck; se il pezzo deve uscire in brand voice stretta, alzi effort o passi a Opus.
Attenzione a una differenza di comportamento segnalata nelle docs: su compiti lunghi, a Low e Medium, Fable 5.2 a volte chiude il turno con un elenco di cose ancora da fare. Se succede, chiedigli di finire il lavoro invece di ripartire da zero.
Flusso tipico che uso sulla redazione, già dentro lo stack Cowork/Skills:
- Apri Cowork con Fable 5.2 (se il selettore lo mostra sul tuo piano).
- Lascia Medium. Non partire da Max.
- Carica fonti (brief, URL, PDF competitor, brand notes).
- Chiedi un deliverable unico: research memo, outline slide, tabella confronto — non tre cose insieme.
- Se la voce non regge, copia umana su Opus 5.5 sul pezzo finale.
Se non hai ancora installato Cowork, parti dalla guida Claude Cowork. Per i pezzi ripetibili (brief tipo, checklist SEO, tone of voice) tieni le Claude Skills.
Quanto costa Claude Fable 5.2 rispetto a Fable 5.1 e Opus 5.5?
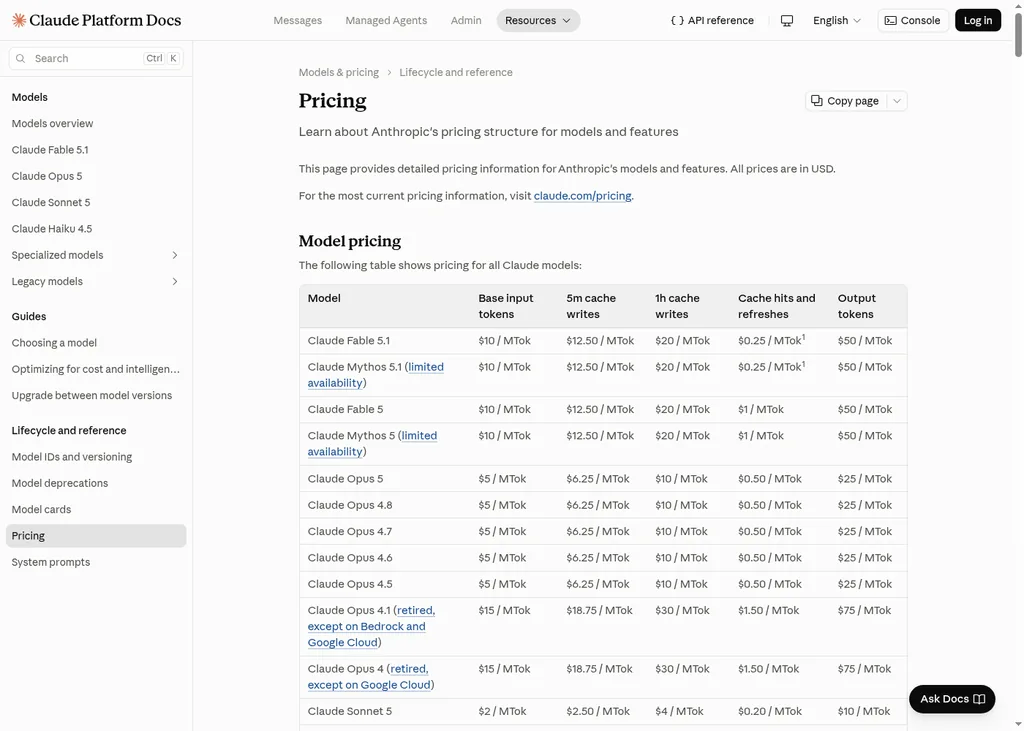
Al 10 novembre 2026, sul listino API Anthropic, Fable 5.2 costa $8 input e $40 output per milione di token: il 20% meno della 5.1 ($10 / $50), ma sempre il doppio di Opus 5.5 ($4 / $20). La cache read non è più un vantaggio: $0,20 / MTok sia su Fable 5.2 sia su Opus 5.5. La fast mode costa $16 / $80.
Tabella letta oggi sul listino Claude Platform:
| Modello | Input / MTok | Output / MTok | Cache write 5m | Cache write 1h | Cache read |
|---|---|---|---|---|---|
| Claude Fable 5.2 | $8 | $40 | $10 | $16 | $0,20 |
| Claude Fable 5.2 fast mode | $16 | $80 | — | — | — |
| Claude Fable 5.1 | $10 | $50 | $12,50 | $20 | $0,25 |
| Claude Opus 5.5 | $4 | $20 | $5 | $8 | $0,20 |
| Claude Sonnet 5.5 | $2 | $10 | $2,50 | $4 | $0,10 |
Note dal vendor (stesse pagine, 10/11/2026):
- Batch API: Fable 5.2 a $4 / $20 (−50%).
- Fable 5.2 richiede 30 giorni di conservazione dei dati e non è disponibile in zero data retention, salvo autorizzazione di Anthropic. Da sapere se lavori con dati di clienti.
- Su alcuni task il costo per task conta più del listino: su WANDR, a Medium, Fable 5.2 eguaglia il miglior punteggio di Opus 5.5 con circa il 40% del costo per task; su Chartography, a Medium, fa 66,4% contro 64,4% di Opus 5.5 a Max con meno di un decimo del costo.
Un conto mio sul listino, per farti un’idea: un memo di research con 200.000 token in input e 20.000 in output, senza cache né tool, costa $2,40 con Fable 5.2, $3,00 con Fable 5.1, $1,20 con Opus 5.5 e $4,80 in fast mode. Fable però ragiona di più a High, quindi i token di output reali di solito salgono.
Come leggerla da marketer, senza inventare volumi:
- Un’email o una landing (pochi turni, poca cache): Opus 5.5 costa la metà. Non ha senso bruciare Fable.
- Un report da dati con grafici o una ricerca su molte fonti: qui il costo per task di Fable 5.2 a Medium può battere Opus 5.5 a effort alto, perché arriva prima al risultato.
- Piano Pro/Max: non paghi solo API. Su Max, Fable mangia fino al 50% dei limiti settimanali. Su Pro, dopo il 16/11, è a usage credits. Controlla il contatore prima di lasciare Fable su ogni chat.
Non invento un “costo medio italiano”. Quello dipende da hit rate della cache e dal tuo volume. La tabella sopra è il pezzo verificabile.
Quando resti su Opus 5.5 e quando passi a Fable 5.2?
Resta su Opus 5.5 per copy corta e voce brand: headline, landing, email, FAQ, post social. Costa la metà e sul knowledge work generico è alla pari (Elo AA-Briefcase 1800 contro 1785). Passa a Fable 5.2 per report con grafici, ricerche su molte fonti, automazioni lunghe in Cowork: lì i benchmark ufficiali lo mettono da 9 a 20 punti sopra.
Regola operativa che uso io:
| Lavoro marketing | Default | Perché |
|---|---|---|
| Headline, meta, CTA, email one-shot | Opus 5.5 | Listino metà di Fable; voce più controllabile sul pezzo corto |
| Landing / sales page da rivedere a mano | Opus 5.5 → tu in chiusura | Opus bozza; tu tagli e firmi |
| Report mensile da export GA4 / Search Console con grafici | Fable 5.2 Medium | Chartography 73,4% contro 64,4% di Opus 5.5 |
| Research competitor 10+ fonti | Fable 5.2 Medium | WANDR 82,1% contro 72,3%; costo per task più basso a Medium |
| Deck 12–20 slide da brief lungo | Fable 5.2 Medium | Documenti, fogli e slide sono il caso d’uso dichiarato |
| Automazione business in più passaggi (CRM, fogli, email in bozza) | Fable 5.2 | AutomationBench 51,4% contro 42,5% |
| Cyber / biologia dual-use | Opus (fallback) | I safeguard di Fable bloccano; Mythos è chiuso |
Il passaggio inverso lo trovi nel pezzo su Claude Opus 5.5 per marketer. Confronti più ampi (non solo Anthropic) restano su Claude Opus vs GPT Codex per il marketing.
Tre segnali che stai sbagliando modello:
- Usi Fable per una subject line: sprechi limiti.
- Usi Opus per un report di 40 pagine con 15 URL e 10 grafici: sprechi turni e contesto.
- Lasci Auto e non sai se gira Fable o Opus: non puoi leggere il costo.
Benchmark di Fable: cosa contano per il tuo lavoro?
I numeri che contano per un marketer sono tre: AutomationBench (workflow business) 51,4%, Chartography (lettura grafici) 73,4% e AA-Briefcase (knowledge work) 66,1% di rubric. Servono a capire dove Fable 5.2 lavora meglio, non a promettere +X% sul tuo funnel.
Il resto della tabella del post ufficiale (10/11/2026) riguarda coding, scienza e robotica: FrontierCode 2.0 49,1%, Humanity’s Last Exam con tool 74,2%, OSWorld 2.1 89,3%. Per confronto, la 5.1 di settembre segnava:
- AutomationBench: Fable 5.1 31,4% vs Fable 5 17,1% (post Fable 5.1, 08/09/2026)
- Terminal-Bench-Science 0.1: Fable 5.1 52,6%; Fable 5.2 ora 74,6%
- OSWorld 2.0 partial: Fable 5.1 77,9%; strict 41,7%
- GDPval-AA v2: Fable 5.1 1853 (Fable 5: 1723; Opus 5: 1824)
Caveat Anthropic, da citare: i punteggi di Fable girano con i safeguard di produzione e all’effort più alto disponibile. Anthropic ammette anche che Fable 5.2 «sospetta» di essere valutato più spesso dei modelli precedenti, e questo rende le eval meno affidabili. Non confrontare questi numeri con benchmark di modelli senza le stesse condizioni.
Per un marketer italiano la lettura onesta è: Fable 5.2 è più forte di Opus 5.5 su report e workflow in più passaggi. Non è prova che la tua campagna Meta o la tua newsletter convertano di più.
Watermark EU AI Act: cosa cambia per te dopo il 02/08/2026?
I modelli Claude rilasciati dopo il 2 agosto 2026, Fable 5.1 incluso, portano un watermark testuale invisibile richiesto dal Code of Practice EU AI Act sulla trasparenza dei contenuti AI. Non altera qualità o significato; non contiene dati su di te. La detection API è in private preview per soggetti eleggibili (regulator, media, enterprise obbligati).
Cosa ti cambia in redazione:
- Se pubblichi copy generata con Fable 5.1, il testo può risultare marcato agli occhi di chi ha la detection API.
- Il watermark non è un badge visibile per il lettore.
- File image/video prodotti via tool supportati possono portare C2PA Content Credentials (docs «What’s new in Fable 5.1»).
- Per compliance interna, registra interest alla detection API se la tua azienda rientra negli obblighi Article 50.
Fonte: sezione «Compliance with the EU AI Act» del post Fable 5.1, ancora accurata oggi 08/09/2026.
L’ho testato: cosa è andato e cosa no
Su Fable 5.2 non ho ancora un test mio al 10/11/2026: i numeri sopra vengono dalle pagine Anthropic, non da una sessione della redazione. Il test qui sotto è su Fable 5.1, del 9 settembre, e lo lascio perché il flusso (selettore, effort, consumo) è lo stesso.
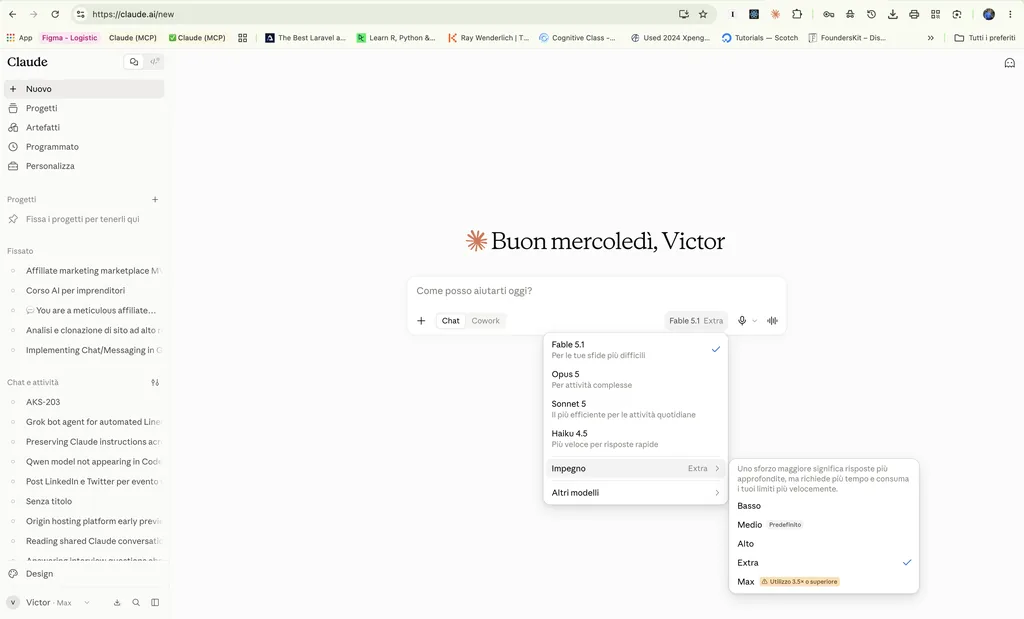
Oggi, 9 settembre 2026, ho aperto claude.ai in sessione Victor · Max (UI italiana, «Buon mercoledì, Victor»). Tab Chat attiva, non Cowork. Nel picker ho selezionato Fable 5.1; sotto Impegno ho messo Extra (checkmark). Medio nel menu è solo etichettato Predefinito — non era selezionato. La pill nell’input conferma «Fable 5.1 Extra». Pricing e overview vendor restano allineati ai numeri sopra (verificati 8–9 settembre 2026).
Cosa ho aperto e catturato io:
- claude.ai/new → profilo Max, Fable 5.1 selezionato, Impegno Extra, tab Chat.
- Docs pricing → riga Fable 5.1 con cache $0,25.
- Docs overview Fable 5.1 → 1M / 128K / $10 /$50 / Latest.
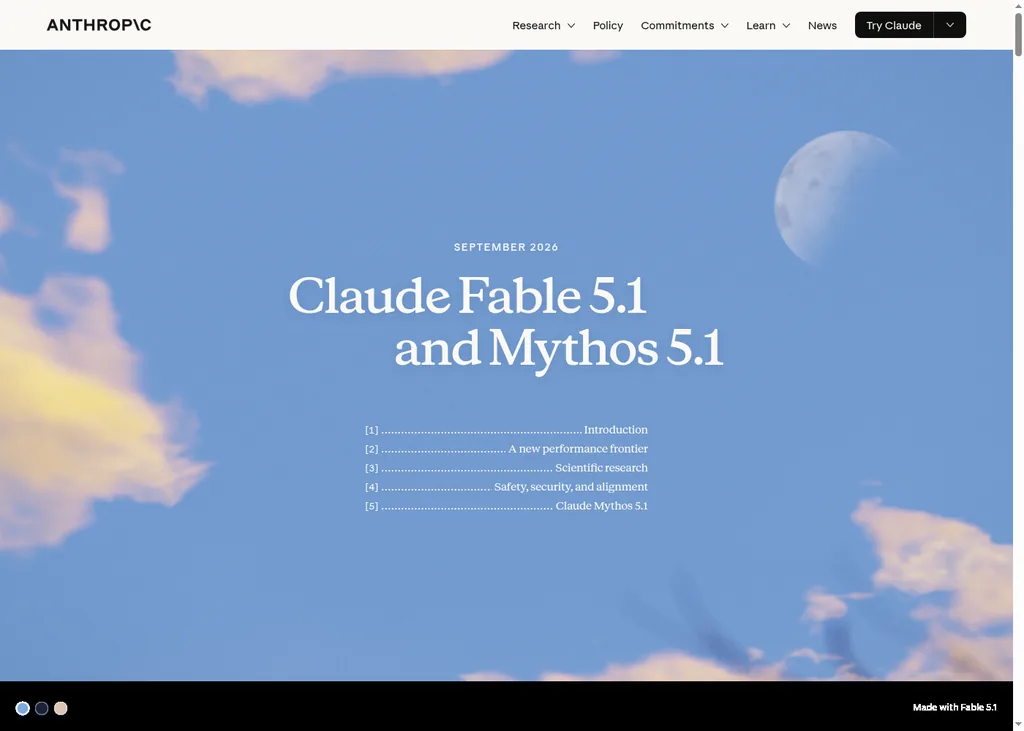
- Post Anthropic Fable + Mythos 5.1 → default Medium in Cowork/claude.ai (vendor); High in Code; AutomationBench 31,4%.
Cosa resta fuori da questo giro:
- Non ho misurato il burn crediti su un brief marketing reale della redazione.
- Non ho confrontato side-by-side Opus vs Fable sullo stesso brief italiano a Extra.
- Il tab Cowork non era attivo nello shot: la prova first-hand è sulla Chat Max con Fable 5.1 Extra.
Il default Medium citato da Anthropic per Cowork/claude.ai resta vero come impostazione di partenza vendor. Nella mia sessione Max di oggi ho alzato a Extra: più profondità, più consumo limiti.
Come lo metti in coda marketing questa settimana
Parti da un solo flusso Cowork su Fable 5.2 a Medium, misura limiti e qualità, poi decidi se allargare. Se sei su Pro hai tempo fino al 16/11 senza usage credits: usalo su un lavoro vero, non su prove a caso. Opus 5.5 resta il default sulla copy da pubblicare.
Checklist in cinque passi:
- Inventario modelli. Su Pro, Max o Ultra verifica che Fable 5.2 compaia nel selettore. Su Free non c’è (pagina prezzi, 10/11/2026).
- Un brief pilota. Report da dati o research su un competitor. Medium. Nessun Max effort al primo giro.
- Chiusura su Opus. Headline, meta, CTA e paragrafi da pubblicazione li passi a Opus 5.5 o li riscrivi tu.
- Skills. Se il brief è ricorrente, salvalo come Skill invece di ripromptare da zero (guida Skills).
- Costo. Se sei su API, cambia l’id in
claude-fable-5-2, rilancia le tue eval e guarda la quota cache read. Se sei su Max, guarda quanto Fable mangia del 50% settimanale.
Stack correlato sulla redazione: agenti AI marketing per il quadro agent, Cowork per il desktop agent, Skills per i pezzi ripetibili.
Domande frequenti su Claude Fable 5.2
Claude Fable 5.2 è lo stesso di Mythos 5.2?
Sì sul motore: Anthropic li descrive come lo stesso modello con safeguard diversi. Fable 5.2 è disponibile su tutti i piani a pagamento e via API. Mythos 5.2 resta alle organizzazioni verificate (cyber e life sciences). Per un marketer italiano il modello accessibile è Fable.
Posso usare Fable 5.2 sul piano Free o Pro?
Sul Free no. Su Pro, fino al 16/11/2026 alle 23:59 del Pacifico (08:59 del 17/11 in Italia), Fable è incluso fino al 50% dei limiti settimanali, più un reset. Dopo torna a usage credits. Su Max e Ultra è incluso fino al 50% dei limiti settimanali.
Fable 5.2 è più economico di Opus 5.5?
Sul listino no: $8 / $40 contro $4 / $20 per milione di token, e la cache read costa uguale ($0,20). Può costare meno per task su report con grafici e ricerche lunghe, dove a Medium arriva al punteggio di Opus 5.5 con una frazione del costo per task.
Il default Medium in Cowork basta per un deck cliente?
Spesso sì per la prima bozza di struttura e contenuti. Se il deck deve uscire “voce agenzia”, rivedi su Opus o a mano. Medium è il punto di partenza dichiarato da Anthropic, non la chiusura qualità.
Devo preoccuparmi del watermark EU AI Act?
Se pubblichi testo generato con modelli post 02/08/2026, il watermark può essere rilevabile da chi ha la detection API. Non cambia la lettura umana. Per policy interne, allinea legal/compliance: non è un badge in pagina.
Se vieni da Fable e vuoi capire quando tornare al modello più economico, leggi Claude Opus 5.5 per marketer.
Conclusione
Claude Fable 5.2, al 10 novembre 2026, costa il 20% meno della 5.1, è più veloce e stacca Opus 5.5 su report con grafici, ricerche lunghe e automazioni in più passaggi. Sulla copy corta Opus 5.5 resta la scelta giusta: costa la metà e sul knowledge work generico è alla pari. Se sei su Pro, usa la settimana fino al 16/11 su un lavoro vero e misura i limiti.
Se ti serve il contesto prodotto prima del modello, leggi la guida Claude Cowork e il quadro sugli agenti AI per il marketing. Fonti primarie: Anthropic — Fable 5.2, offerte di lancio e listino API.
Autore: Victor Motricala — consulente marketing e AI. Scrivo playbook operativi per marketer italiani su victormotricala.it.
