Aggiornato il 11/11/2026: cosa è cambiato. Ho aggiunto come rivendicare l’attività su ChatGPT (Business Hub), come rendere il negozio trovabile dagli agenti AI che comprano, una tabella robots.txt / sitemap.xml / llms.txt, il report AI Performance di Bing Webmaster Tools per misurare le citazioni su Copilot e Bing, e tre FAQ (pixel ads vs citazioni, ChatGPT Sites, opt-out dal training). Il testo del 21/09 resta, dove non è superato.
Per farsi citare da ChatGPT e Perplexity in Italia ti serve una pagina che risponde alla query in 40-60 parole, un dato con fonte, i crawler di search aperti e un protocollo di misura. Non un file magico e non un markup copiato. Due stati contano: citato con link e menzionato senza URL. Il terzo è assente, ed è quello in cui stai quasi sempre.
Il 12 agosto 2026, sul mio set settimanale di 18 prompt italiani, victormotricala.it aveva Share of Voice 11,1%: 1 cited_with_link, 1 mentioned_no_link, 16 absent. Sui prompt AEO e citazione eravamo assenti. Su Perplexity la citazione è arrivata solo sulla query di brand. I competitor che prendevano spazio erano micro-blog italiani, quindi il mercato è contendibile.
Il metodo in 5 passi sta nella guida AEO in 5 passi. Questa pagina è il playbook operativo: come entrare nella risposta, come non uscirne, come misurare senza inventare numeri.
Cosa serve sapere in 30 secondi
Per farsi citare da ChatGPT e Perplexity tu usi una pagina che risponde in 40-60 parole, un dato con fonte, i crawler di search aperti e un set di prompt che misuri ogni settimana. Il resto è dettaglio. Il campione del 12 agosto 2026 sta sotto.
- Una citazione AI è quando ChatGPT Search o Perplexity usano la tua pagina per costruire la risposta. Con link o solo menzione. Assente è il terzo stato, e sul mio campione è il più frequente.
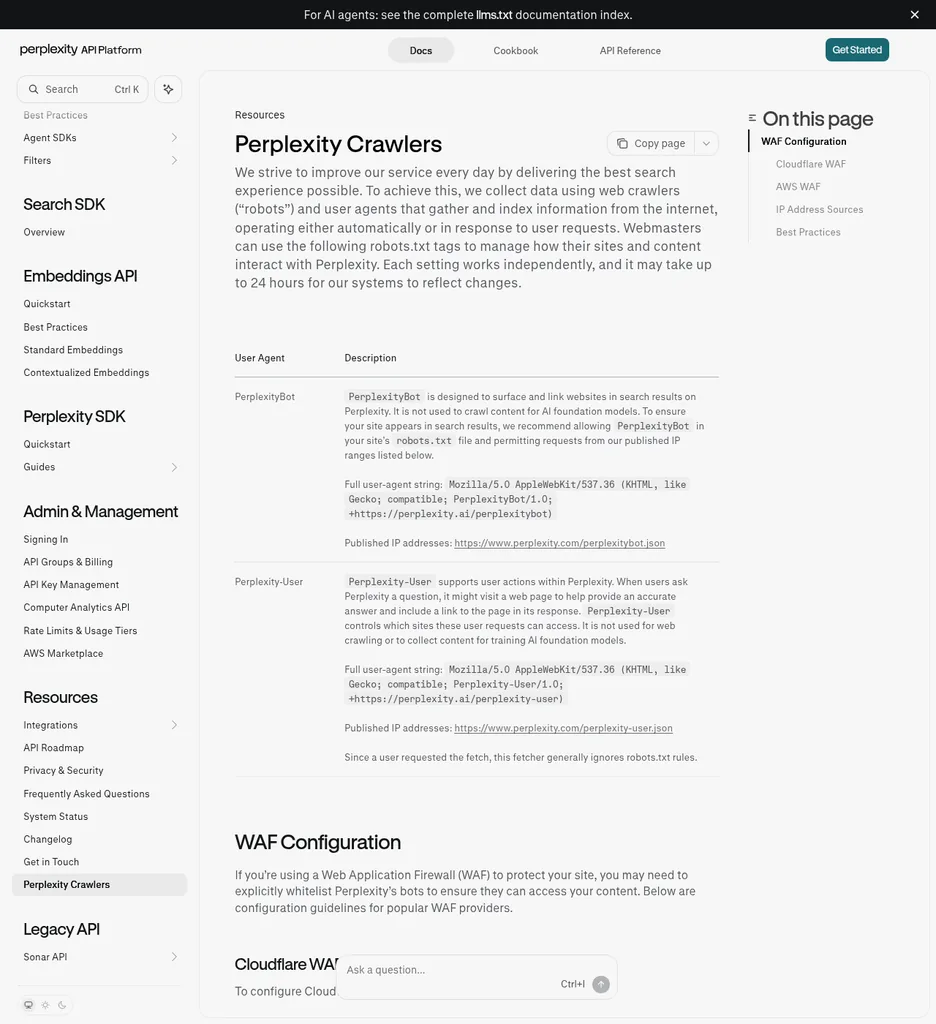
- ChatGPT Search decide l’inclusione con OAI-SearchBot. Perplexity con PerplexityBot. GPTBot è training, non search. I fetch utente (ChatGPT-User, Perplexity-User) in genere ignorano robots.txt.
- Il 12 agosto 2026, su 18 prompt italiani, SoV 11,1%: 1 citazione con link, 1 menzione, 16 assenze. Assenti sui prompt AEO. Su Perplexity citati solo sul brand.
- La pagina citabile apre con 40-60 parole autonome, un dato attribuibile e un H2 per task. Il preambolo «in questo pezzo parliamo di» non viene estratto.
- robots.txt del 17 agosto 2026 su victormotricala.it:
User-agent: *eDisallow:vuoto, quindi aperto. llms.txt esiste, al 11/11/2026 è in italiano, e non ho misurato un lift di citazioni da quel file. - Misuri con lo stesso set, stessa cadenza, tre stati. Search Console, se hai il report Generative AI, lo guardi per le impression. Un numero che non hai non lo pubblichi.
Passi per farsi citare (allineati a OpenAI e Google)
Su ChatGPT Search la risposta a «come far citare il mio sito» arriva a passi e cita le guide publisher di OpenAI e, sul lato Google, le regole crawler di Search. Qui sotto è la stessa logica, in italiano, senza inventare un ranking factor. Otto passi che puoi eseguire oggi.
- Apri la pagina di categoria (non solo brand) e riscrivi le prime 40-60 parole così rispondono da sole alla query. Data e fonte nel blocco, non in calce.
- Controlla
robots.txt: OAI-SearchBot e PerplexityBot devono poter leggere. UnDisallow: /su OAI-SearchBot ti toglie dalle search answers di ChatGPT (fonte: help.openai.com publisher FAQ, ricontrollata il 21/09/2026). - Separa training e search. GPTBot Disallow se non vuoi il training; OAI-SearchBot Allow se vuoi restare citabile. Le due regole sono indipendenti (developers.openai.com/api/docs/bots).
- Su Google tieni Googlebot aperto per Search (AI Overviews e AI Mode usano lo stesso crawl di Search). Google-Extended è il token separato per training/grounding Gemini: puoi chiuderlo senza uscire da Search (developers.google.com/search/docs/appearance/ai-features).
- Se sei su Cloudflare, preferisci Disallow AI Training a Block: Block oggi può tagliare anche Googlebot/Applebot/Bingbot. Disallow AI Training pubblica la preferenza no-training e lascia i crawler Accountable in search.
- Scrivi frasi autosufficienti, FAQ visibili allineate allo schema, bio autore chiara. Non è un trucco: è il formato che i modelli estraggono senza contesto precedente.
- Aspetta circa 24 ore dopo un cambio robots.txt, poi rilancia lo stesso set di 5-8 prompt italiani. Segna cited_with_link / mentioned_no_link / absent. Referral Analytics ≠ citazione.
- Rinnova le placement esterne: negli esperimenti GEO di Search Engine Land del 14/09/2026 circa metà delle fonti smetteva di essere citata entro ~30 giorni. Una listicle guadagnata decade; non è un asset «set and forget».
Cos’è una citazione AI (con link vs solo menzione)
Una citazione AI è il momento in cui ChatGPT Search o Perplexity usano la tua pagina per costruire la risposta. Due stati utili: cited_with_link (nome + URL visibile) e mentioned_no_link (brand o concetto, senza URL). Assente è il terzo stato. Sul mio campione del 12 agosto 2026 è quello più frequente: 16 prompt su 18.
La distinzione non è accademica. Una menzione senza link ti dà brand awareness nella risposta, zero click diretto. Una citazione con link ti mette nel percorso: l’utente può aprire la pagina. Io registro entrambi, perché un brand che passa da assente a menzionato sta già entrando nel set di fonti. Un brand che resta assente sui prompt di categoria sta regalando la risposta a un micro-blog.
Tre esempi italiani, stesso meccanismo, tre tipi di sito.
Servizio locale. Uno studio dentistico a Bologna pubblica «quanto costa un impianto a Bologna nel 2026» con un range, la data del listino e la fonte (il proprio tariffario, aggiornato). Se Perplexity risponde «secondo lo Studio X un impianto parte da…» e mette il link, quella è cited_with_link. Se dice «alcuni studi bolognesi partono da…» senza nome, sei invisibile anche se il modello ha letto la pagina.
SaaS B2B. Una piattaforma di fatturazione elettronica pubblica «come si calcola la ritenuta d’acconto per un professionista». Apre con la formula, cita l’Agenzia delle Entrate, chiude con un esempio numerico. Se ChatGPT Search usa quel blocco e linka la guida, hai vinto il prompt di categoria. Se usa Wikipedia e un forum, la tua landing page da 3.000 parole non è citabile: è un saggio.
Sito di contenuti, come questo blog. Io misuro prompt del tipo «come farsi citare da ChatGPT» e «cos’è l’AEO». Il 12 agosto 2026 su quei prompt ero assente. La citazione è arrivata sulla query di brand. Tradotto: il modello mi conosce se gli chiedi di me. Non mi usa ancora come fonte di categoria. Questo playbook esiste per chiudere quel buco, non per raccontarti cos’è l’AEO.
Quando tu misuri, non fondere i due stati. «Ci hanno citato» senza dire se c’era il link è un report inutile. Io segno: motore, prompt, data, stato (cited_with_link / mentioned_no_link / absent), dominio che ha preso il posto tuo. Quella riga, ripetuta ogni settimana, è l’unico KPI che tengo.
ChatGPT e Perplexity citano in modo diverso?
Sì. ChatGPT Search decide l’inclusione con OAI-SearchBot; Perplexity con PerplexityBot. I fetch dell’utente (ChatGPT-User e Perplexity-User) possono aprire una pagina anche se robots.txt la chiude, ma non decidono l’indicizzazione. La cadenza dichiarata per i cambi di robots.txt è circa 24 ore su entrambi i lati.
Non ho un ranking factor ufficiale da venderti. Ho le schede bot e un campione. Ecco dove i due motori si separano, con fonti e senza numeri inventati.
| Dimensione | ChatGPT Search | Perplexity |
|---|---|---|
| Bot di search / indicizzazione | OAI-SearchBot: serve a far comparire i siti nelle risposte con ricerca. Se lo blocchi, non appari nelle search answers; i link di navigazione possono restare. Fonte: documentazione bot OpenAI. | PerplexityBot: serve a far emergere e linkare i siti nei risultati Perplexity. Non è usato per il training dei foundation model. Fonte: documentazione crawler Perplexity. |
| Bot di training | GPTBot: crawl per i foundation model. Indipendente da OAI-SearchBot. Puoi chiudere il training e lasciare aperto il search. | PerplexityBot, per dichiarazione ufficiale, non raccoglie contenuti per il training. |
| Fetch utente | ChatGPT-User: visita innescata da una domanda o da un’azione in ChatGPT / Custom GPT. Non è un crawl automatico. robots.txt può non applicarsi. Non decide l’inclusione in Search. | Perplexity-User: visita innescata dalla domanda, per rispondere e includere un link. In genere ignora robots.txt. Non è training. |
| Freshness dichiarata | Un aggiornamento di robots.txt può richiedere circa 24 ore. | Un aggiornamento di robots.txt può richiedere fino a 24 ore. |
| Cosa ho visto sul campione del 12 agosto 2026 | Assente sui prompt AEO e citazione del set. | Citato solo sulla query di brand; assente sui prompt AEO e su quelli sugli agenti AI. |
Due implicazioni, se tu le applichi al tuo robots.txt.
Se tu chiudi GPTBot e lasci aperto OAI-SearchBot, stai dicendo «non usarmi per addestrare, usami per rispondere». È un perimetro, non un ranking boost. Se un utente chiede di aprire una URL tua, ChatGPT-User o Perplexity-User possono fetcharla anche con un Disallow: quella visita non ti mette in Search.
Perplexity, sul mio uso, elenca le fonti in modo più esplicito. ChatGPT Search le mescola nel testo. Non ho un paper che quantifichi il gap. Sul campione la citazione Perplexity è arrivata sul brand, non sulla categoria. Quadro tool, non citazioni: Perplexity Computer.
ChatGPT classico vs ChatGPT Search
Non sono lo stesso prodotto. Se tu ottimizzi «per ChatGPT» senza dire quale, misuri aria. Tabella minima, senza numeri di caso studio inventati.
| ChatGPT classico (chat) | ChatGPT Search | |
|---|---|---|
| Come arriva alla tua pagina | Memoria del modello + eventuali fetch utente (ChatGPT-User) | Crawl e indicizzazione via OAI-SearchBot |
| Cosa controlli tu | Qualità della pagina e coerenza entity; GPTBot se ti interessa il training | robots.txt su OAI-SearchBot, WAF, blocco risposta 40-60 parole |
| Citazione con link | Meno prevedibile; spesso menzione senza URL | Obiettivo principale del playbook: cited_with_link nelle search answers |
| Leva pratica | Frasi autosufficienti, FAQ+schema, bio autore | Stesso contenuto + crawler di search aperti + misura settimanale |
Tre tecniche ad alto impatto, banali da verificare in preview: (1) ogni frase chiave regge da sola se la incolli in un prompt; (2) FAQ visibili e FAQPage allineati al testo; (3) autore con nome, ruolo e pagina «chi sono» linkata. Non invento un moltiplicatore: è il formato che i modelli riescono a sollevare.
Cosa ho misurato su 18 prompt italiani
Il 12 agosto 2026, sullo stesso set settimanale di 18 prompt italiani, victormotricala.it aveva Share of Voice 11,1%: 1 cited_with_link, 1 mentioned_no_link, 16 absent. Sui prompt AEO e citazione eravamo assenti. Su Perplexity la citazione è arrivata solo sulla query di brand. I competitor erano micro-blog italiani, contendibili.
Il protocollo lo gira un bot della redazione, ogni settimana, sugli stessi prompt, su Grok, ChatGPT e Perplexity. Per ogni riga segno tre stati e il dominio che ha preso il posto. Quando Search Console espone il report Generative AI, lo incrocio sulle impression. Non pubblico un numero GSC che non ho in mano.
Cosa legge un marketer da quel campione, senza ricamarci sopra.
Il brand passa, la categoria no. Se ti chiedono «chi è Victor Motricala» o «victormotricala.it AEO», il modello ha una fonte. Se ti chiedono «come farsi citare da ChatGPT» o «AEO in Italia», usa altri. Il buco non è di notorietà grezza: è di pagina citabile sul prompt di categoria.
16 assenze su 18 non sono una condanna. I siti citati erano micro-blog italiani, non testate. La query è contendibile: una pagina che ha risposto prima di te, non il Corriere.
SoV 11,1% su un set piccolo. SoV = (cited_with_link + mentioned_no_link) / prompt. 2 / 18 = 11,1%. È un termometro ripetibile, non una quota di mercato.
Assente sui prompt AEO è il brief. Il pillar esiste ed è locked. Qui non lo riscrivo. Qui costruisco la pagina che quel set dovrebbe poter citare al prossimo giro.
Set che tu puoi copiare e adattare. Io ne tengo di questo tipo, in italiano, sempre gli stessi, settimana su settimana:
- Come farsi citare da ChatGPT in Italia
- Come farsi citare da Perplexity
- Cos’è l’AEO e come si misura
- Differenza tra citazione con link e menzione senza link
- Come aprire GPTBot e OAI-SearchBot in robots.txt
- llms.txt serve per farsi citare
- Migliori guide AEO in italiano
- Victor Motricala AEO (controllo brand)
Se tu vendi un servizio locale, scambia i primi tre con «quanto costa un [servizio] a [città]», «miglior [servizio] a [città] 2026», «[servizio] [città] recensioni vere». Se tu vendi un SaaS B2B, usa «come si calcola [obbligo]», «[tool] vs [tool] per PMI italiane», «obbligo [norma] per [ruolo]». Il punto non è il prompt furbo. È la ripetizione.<!– IMG: optional later screenshot of Perplexity citation on the brand query, if Victor provides –>
Come scrivere una pagina che un modello può citare
Apri con 40-60 parole che rispondono da sole, metti un dato con fonte, tieni un H2 per task, chiudi con una procedura copiabile. Il modello estrae il blocco autonomo. Se il primo paragrafo è un preambolo, la tua pagina non è citabile: è un saggio che aspetta un lettore paziente.
Due aperture, stessa query: «come farsi citare da ChatGPT».
Non citabile:
«Sempre più persone usano gli assistenti AI per informarsi e le aziende si chiedono come comparire in quelle risposte. In questa guida ti accompagno passo dopo passo nel nuovo modo di fare visibilità, partendo dalle basi e arrivando a una strategia completa.»
Zero risposta, zero dato, zero fonte. Un modello che deve citare una frase se ne va da un’altra parte.
Citabile:
«Per farsi citare da ChatGPT in Italia ti serve una pagina che risponde in 40-60 parole, un dato con fonte, OAI-SearchBot aperto e un set di prompt che misuri ogni settimana. Il 12 agosto 2026, su 18 prompt italiani, questo sito aveva SoV 11,1%: 1 citazione con link, 1 menzione, 16 assenze.»
Stessa query. Una frase che un modello può sollevare intera. Data, numeratore, denominatore, fonte (il mio monitor). Se copi la struttura e inventi i numeri, stai costruendo una pagina che mentirà anche al crawler. Non lo fare.
Tre regole che uso io, e che tu applichi a un dentista, a un SaaS o a un blog.
Risposta prima del contesto. Ogni H2 è una domanda o un task. Le prime 40-60 parole chiudono la domanda. Il resto è prova, esempio, eccezione. Se togli il resto, il blocco regge da solo. È il test che faccio in anteprima: copio i primi 50 parole, li incollo in un prompt, chiedo «questa frase risponde?». Se la risposta è no, riscrivo.
Un dato, una fonte, una data. «Molti siti ottengono più citazioni con lo schema» non è un dato. «Il 12 agosto 2026, su 18 prompt, 1 cited_with_link» è un dato. Se non hai la fonte, togli il numero. Preferisco una frase senza cifra a una cifra presa da un blog competitor che non ho verificato.
Una procedura numerata, non un manifesto. Il modello ama le liste che un umano può eseguire. «Apri robots.txt, cerca OAI-SearchBot, se manca aggiungi Allow, aspetta 24 ore, rilancia il prompt» è citabile. «Ottimizza la presenza sui motori conversazionali» non lo è.
Il tono conta. Io scrivo in prima persona, do del tu, evito il copy da landing page. Se il testo sembra un comunicato, umanizzalo prima di pubblicare. Se parti da una bozza di ChatGPT, sappi che in UE i testi idonei porteranno un watermark invisibile: la tua revisione e la tua firma restano ciò che conta, anche per l’AI Act. Un modello che deve scegliere una fonte preferisce una pagina che suona come un operatore, non come un comunicato stampa.
Schema FAQPage: lo uso su domande vere già visibili. Tipo ufficiale: FAQPage su schema.org. Non ho un paper che lo dimostri come moltiplicatore. Se il markup è solo nel JSON-LD, stai mentendo al parser.
Come aprire i crawler (robots.txt, GPTBot, OAI-SearchBot, PerplexityBot)
Apri OAI-SearchBot e PerplexityBot in robots.txt se tu vuoi comparire nelle risposte con ricerca. GPTBot è training, indipendente dal search. I fetch utente in genere ignorano robots.txt. Una modifica può richiedere circa 24 ore, schede OpenAI e Perplexity.
Ogni motore non pesca dallo stesso pozzo. Questa è la mappa, ricontrollata sulle pagine ufficiali l’11/11/2026. Non ho trovato, in data odierna, una pagina ufficiale OpenAI che renda Bing Webmaster Tools un prerequisito per comparire in ChatGPT Search: per ChatGPT conta OAI-SearchBot e gli IP pubblicati.
| Motore | Da dove tira i contenuti | Cosa controlli tu |
|---|---|---|
| Google AI Mode, AI Overviews, Gemini | L’indice di Google, tramite Googlebot e le regole di Search | Search Console, sitemap, robots.txt; il report Generative AI solo se lo vedi nel tuo account |
| ChatGPT Search | Il crawl di OAI-SearchBot, indipendente da GPTBot | Allow su OAI-SearchBot in robots.txt e richieste dagli IP pubblicati da OpenAI. Fonte: documentazione crawler OpenAI |
| Perplexity | Il crawl di PerplexityBot | Allow su PerplexityBot; i fetch Perplexity-User in genere ignorano robots.txt |
| Microsoft Copilot e riassunti AI di Bing | L’indice e le esperienze AI di Bing | Bing Webmaster Tools e il report AI Performance (citazioni, pagine citate, grounding queries) |
Il 17 agosto 2026 ho ricontrollato https://www.victormotricala.it/robots.txt. Contenuto:
User-agent: *
Disallow:
Disallow: vuoto, su User-agent: *, significa aperto a tutti, crawler AI compresi. Non è una configurazione sofisticata. È la configurazione minima che non ti tiene fuori.
Procedura che uso quando audito un sito cliente, in ordine.
- Apri
https://tuodominio.it/robots.txtda browser in incognito. Se 404, per i bot sei in default: in genere crawlabile, ma non hai dichiarato nulla. Pubblica il file. - Cerca
Disallow: /suUser-agent: *. Se c’è, stai chiudendo il sito intero. Toglilo, a meno che il sito sia privato per scelta. - Cerca blocchi espliciti su
GPTBot,OAI-SearchBot,ChatGPT-User,PerplexityBot,Perplexity-User. UnDisallow: /su OAI-SearchBot ti toglie dalle search answers di ChatGPT. UnDisallow: /su PerplexityBot ti toglie dai risultati Perplexity. - Decidi il perimetro training vs search. Se non vuoi finire nei foundation model ma vuoi restare citabile:
User-agent: GPTBot+Disallow: /, eUser-agent: OAI-SearchBot+Allow: /. Le due regole sono indipendenti, lo scrive OpenAI. - Se hai Cloudflare o un WAF, robots.txt non basta. Perplexity documenta il whitelist di PerplexityBot e Perplexity-User per user-agent e IP. Gli IP ufficiali stanno su https://www.perplexity.com/perplexitybot.json e https://www.perplexity.com/perplexity-user.json. OpenAI pubblica i range sulle stesse schede bot. Se il WAF droppa il bot, il file aperto è teatro.
- Aspetta circa 24 ore. Poi rilancia i prompt del set. Non «ottimizzare». Rilanciare.
Esempio minimo, sito aperto a search e a training:
User-agent: *
Disallow:

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Allow: /
Esempio search sì, training no:
User-agent: *
Disallow:

User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
ChatGPT-User e Perplexity-User non sono una leva di inclusione. OpenAI: ChatGPT-User non decide se appari in Search. Perplexity: Perplexity-User ignora in genere robots.txt. Se tu li blocchi nel WAF, puoi rompere la risposta di chi ha già chiesto la tua URL. Lasciarli aperti evita un falso negativo, non «sblocca» le citazioni.
Nei log cerca i nomi dei bot, non un voto da tool. Se tu vedi ChatGPT-User e zero OAI-SearchBot, hai visite su domanda, non un’indicizzazione di search. Le stringhe complete e gli IP stanno nelle due schede ufficiali.
Cloudflare: Disallow AI Training non è Block
Se il sito passa da Cloudflare, robots.txt da solo non basta: il dashboard decide cosa arriva al bordo. Al 21 settembre 2026 la distinzione utile è questa.
| Impostazione | Cosa fa | Effetto su citazioni |
|---|---|---|
| Disallow AI Training | Pubblica la preferenza no-training; i crawler Accountable (search) restano ammessi; i training-only tipo GPTBot vengono bloccati | Puoi restare in Search / ChatGPT Search senza alimentare il training |
| Block (AI bots) | Blocco largo: include anche mixed-use come Googlebot, Applebot, Bingbot | Rischi di uscire da Google e dagli AI answer che dipendono da quel crawl |
| GPTBot Disallow + OAI-SearchBot Allow | Regola robots.txt indipendente, confermata da OpenAI | Search può citarti; il foundation training no |
Fonte operativa: blog Cloudflare «Have it both ways» / Accountable mixed-use, ricontrollato in edit day. Se vuoi essere citato e non «donato» al training, parti da Disallow AI Training, non da Block.
Dal 04/11/2026 Cloudflare ha anche le policy per i Personal Assistants (agenti che agiscono per una persona). In Security Settings, sezione «AI Crawler and Agent access policies», imposti una regola generale per gli Agents e poi una diversa per ogni agente supportato: Allow (non bloccare), Block on pages with ads (blocca sulle pagine con pubblicità) o Block. Le policy Search e Training restano quelle di prima. Fonte: annuncio Cloudflare del 04/11/2026. Non ho testato il dashboard su questo sito: la riga ripete solo la pagina ufficiale.
llms.txt serve davvero?
llms.txt è un file in root che elenca le pagine che vuoi far leggere a un modello. Non è un interruttore di citazione. L’11/11/2026 ho riletto https://www.victormotricala.it/llms.txt: ora è in italiano e elenca le pagine principali, alcune comparazioni e i profili. Non ho misurato un lift di citazioni attribuito a quel file. L’allineamento dell’elenco ai pillar (coda 2026-08-12-t01) è ancora aperto, quindi qui non copio un esempio da usare come modello.
Prima di innamorarti di un file, tieni distinta la funzione di ciascuno.
| File | Cosa fa | Chi lo legge |
|---|---|---|
robots.txt | Dice a ogni user-agent cosa può o non può scaricare. È il primo controllo su training e search. | Googlebot, Bingbot, OAI-SearchBot, GPTBot, PerplexityBot e gli altri crawler che rispettano il file |
sitemap.xml | Elenca gli URL da scansionare, con data di modifica. Non decide se un modello ti cita. | Motori di ricerca a cui lo invii (Google Search Console, Bing Webmaster Tools) |
llms.txt | Mappa volontaria delle pagine che vuoi far leggere a un modello. Non è uno standard di indicizzazione e non sostituisce una pagina ben scritta. | Gli strumenti che scelgono di aprirlo; non c’è un obbligo ufficiale dei grandi motori |
Come lo userei, senza promettere un effetto.
- Lingua del file = lingua del sito. Il mio è in inglese su un blog italiano. È il primo fix in coda.
- Lista corta di URL canoniche, quelle che vuoi vedere citate, non una sitemap dump.
- Una riga di contesto per URL, non un claim di marketing.
- Aggiornamento quando pubblichi un pillar nuovo, non «una volta all’anno».
Cosa non fare: vendere llms.txt come il robots.txt delle AI. robots.txt ha una spec. llms.txt è una convenzione. Se un vendor lo legge, bene. Se non lo legge, la tua pagina deve restare citabile da sola. Io lo tengo e lo aggiornerò. Un lift lo pubblicherò solo con data. Oggi quel numero non esiste.
Checklist per farsi citare
La checklist è azione / fatto se. La usi come gate prima di pubblicare e come audit mensile. Se una riga è rossa, non hai un problema astratto di visibilità: hai un blocco concreto (crawler, risposta, dato, misura). Sul mio sito, al 17 agosto 2026, crawler e file ci sono; la pagina di categoria su questo prompt è questo pezzo.<!– IMG: checklist table is the visual; optional later screenshot of Perplexity citation if Victor provides –>
| Azione | Fatto se |
|---|---|
| Pagina che risponde al prompt di categoria, non solo al brand | Esiste un URL il cui H1 è la query (o un equivalente stretto) e le prime 40-60 parole chiudono la domanda da sole |
| Dato con fonte e data in above the fold | C’è almeno un numero attribuibile (campione, listino, norma, doc ufficiale). Se manca la fonte, il numero non c’è |
| H2 come domanda o task | Ogni sezione si regge se la copi e la incolli in un prompt |
| Procedura numerata eseguibile | Un umano può seguire i passi senza interpretare |
| OAI-SearchBot consentito | robots.txt non ha Disallow: / su OAI-SearchBot. Verificato da URL pubblico, non da plugin |
| PerplexityBot consentito | Stesso controllo su PerplexityBot. Fonte regole: docs Perplexity |
| GPTBot deciso in modo esplicito | Allow o Disallow, per scelta, non per dimenticanza. Indipendente dal search |
| WAF non droppa i bot | Log o regola Cloudflare/AWS con user-agent + IP ufficiali, se hai un WAF |
| llms.txt presente e allineato | Il file elenca i pillar vivi, nella lingua del sito. Non lo tratti come switch |
| Schema FAQPage solo su FAQ visibili | Markup = testo in pagina. Tipo: schema.org/FAQPage |
| Set di 5-8 prompt italiani fissi | Stesso wording ogni settimana, brand + categoria + competitor |
| Protocollo a tre stati | cited_with_link / mentioned_no_link / absent, con data e motore |
| Dominio sostitutivo annotato | Se sei assente, sai chi è stato citato al posto tuo |
| GSC Generative AI, se disponibile | Guardi le impression. Non pubblichi un click o un’impression che non hai |
| Refresh della pagina quando il campione resta assente | Se per 2-3 cicli sei assente sul prompt di categoria, riscrivi l’apertura, non «aspetti il boost» |
Tre profili, stessa tabella, tre priorità diverse.
Servizio locale. Manca il dato con fonte: listino datato, range, norma. Senza quello il modello cita un directory. Una pagina «quanto costa X a Y» batte una home da 12 sezioni.
SaaS B2B. La riga che manca è la procedura. Tu hai un blog che spiega il mercato e zero pagine che eseguono il calcolo. Il prompt «come si calcola X» vuole un blocco, non un thought leadership.
Blog di contenuti. La riga che manca, sul mio campione, è la pagina di categoria citabile. Il brand è coperto. Il prompt «come farsi citare da ChatGPT» non lo era. Questa URL esiste per chiudere quella riga.
Errori che ti tengono fuori dalle risposte
I tre errori che ti tengono fuori: crawler chiuso, apertura che non risponde, zero protocollo di misura. Schema copiato e llms.txt vuoto non compensano. Sul mio campione i competitor erano micro-blog italiani: se sei assente, la query è contendibile, non «già persa».
Elenco corto, quello che vedo negli audit.
- Disallow su OAI-SearchBot o PerplexityBot, spesso messo da un plugin «block AI» che non distingue training e search. Chiudi GPTBot se vuoi. Non chiudere il search bot se vuoi la citazione.
- WAF che droppa il bot mentre robots.txt è aperto. Il file dice sì, il firewall dice no. Il modello non discute: passa oltre.
- Apertura da saggio. Prime 80 parole senza risposta. Il modello non «capisce il tuo brand»: estrae un blocco. Se il blocco non c’è, cita un micro-blog che ce l’ha.
- Numeri senza fonte. «Il 70% delle aziende…» senza paper. Io non li metto. Se li metti, un modello che verifica le fonti ti scarta o ti parafrasa senza link.
- Pagina solo brand, zero categoria. Hai «chi siamo» e case study. Non hai «come si fa X in Italia». Il 12 agosto 2026 io ero esattamente lì sui prompt AEO.
- Misura a sensazione. «Mi sembra che ChatGPT ci citi di più.» Senza set fisso non sai se è vero. Il protocollo sotto è banale e tiene.
- llms.txt come scusa per non scrivere. Il file non sostituisce la pagina. Il mio, al 17 agosto 2026, è la prova: esiste, è indietro, e non l’ho usato come alibi.
- Copiare un playbook americano e tradurlo. I prompt in inglese su un mercato italiano misurano un altro utente. Tieni il set in italiano.
Nessuno di questi errori si sistema con un tool nuovo. Se tu li hai in casa, si sistemano con una riga della checklist.
Come misurare se ti stanno citando (senza inventare numeri)
Misuri con un set fisso di prompt, stessa cadenza, tre stati. Io lo faccio ogni settimana su Grok, ChatGPT e Perplexity, con un bot della redazione. Search Console, se hai il report Generative AI, lo uso solo per le impression. Un numero che non ho non lo pubblico.
Il protocollo, copiabile.
- Fissa 5-8 prompt in italiano. Brand, categoria, un competitor, un task operativo. Non cambiarli ogni lunedì. Se ne aggiungi uno, non togliere gli altri: perdi la serie.
- Lanciali lo stesso giorno, sugli stessi motori. Io: Grok, ChatGPT, Perplexity. Stesso wording, niente parafrasi «per vedere se…». La parafrasi è un prompt nuovo.
- Segna un solo stato per riga. cited_with_link, mentioned_no_link, absent. Se c’è il nome e non l’URL, è menzione. Se c’è l’URL, è citazione. Se non ci sei, assente.
- Annota chi ha preso il posto. Dominio, non «un blog». Serve a capire se il competitor è un micro-sito (contendibile) o una fonte istituzionale (altra partita).
- Calcola SoV sul set, non sul mercato. (citazioni + menzioni) / prompt. Il 12 agosto 2026: 2 / 18 = 11,1%. Su 18 righe è un termometro interno. Non è una quota di mercato Italia.
- Incrocia GSC solo se il report c’è. Impression del report Generative AI, quando disponibile. Non click inventati, non «abbiamo +X% di visibilità AI». Se il numero non è nel report quella settimana, quella cella resta vuota.
- Non promuovere un aneddoto a trend. Una citazione sul brand non è «siamo entrati in Perplexity». È una riga. La categoria assente resta assente finché non cambia stato.
Cosa non è misura: uno screenshot isolato, un prompt diverso ogni volta, un tool che ti dà un «AI score» senza mostrare i prompt. Se il vendor non ti fa vedere la query, tu stai comprando un voto.
Per Copilot e i riassunti AI di Bing aggiungi il report AI Performance in Bing Webmaster Tools (in preview dal 10/02/2026, ancora aggiornato a ottobre 2026 con Topics Portfolio). Ti mostra citazioni visibili, pagine citate e grounding queries, in aggregato, non il testo del singolo prompt. Search Console: il report Generative AI lo uso solo se è visibile nel tuo account; oggi non ho ricontrollato l’interfaccia di questo sito, quindi quella cella resta «se c’è».
Il monitor gira in redazione. Stack: agenti AI per il marketing e Grok Bot. Qui conta il contratto: stessi prompt, tre stati, nessuna cifra di fantasia. Se tu resti assente due o tre cicli sul prompt di categoria, torni alla checklist e rilanci. Il campione del 12 agosto 2026 è un punto di partenza, non un trofeo.<!– IMG: optional later screenshot of the AEO Monitor sheet (prompt / stato / dominio), if Victor provides –>
Protocollo GEO (da esperimenti SEL 14/09/2026)
Search Engine Land ha pubblicato il 14 settembre 2026 due esperimenti GEO strutturati. Non riscrivo «cos’è GEO»: piego solo il protocollo che un marketer italiano può usare la settimana dopo.
- Decay ~30 giorni. Circa metà delle fonti citate smetteva di comparire entro un mese. Budget di maintenance, non solo di publish.
- Earned listicle > owned listicle sul cold start. Nelle placement osservate, le listicle di terzi pesavano ~85,8% delle menzioni vs ~14% owned. La pagina owned resta fondamenta; non è il motore primario di cold-start.
- Referral ≠ citazione. Indie Hackers poteva vincere di volume citazioni e restare piatto in sessioni; altre fonti con meno citazioni portavano più traffico. Io tengo due colonne separate nel foglio.
- Target list dalle citazioni osservate. Prima lanci i 15 keyword commerciali sui motori, poi fai outreach dove i modelli citano già, non da una lista Domain Rating generica.
Numeri citati solo dove SEL li ha pubblicati. Nessun case study nostro inventato sopra.
Domande che mi fanno i marketer
Le domande sotto sono quelle che sento dopo un audit di citazioni, più sei FAQ aggiornate a settembre 2026 (Reddit/GEO, markdown, directory «best software», numeri Perplexity, llms-full, Sponsored Agents). Risposte corte. Se ne hai un’altra, parte dal protocollo di misura, non da un plugin «block AI».
Serve pagare ChatGPT Plus o Perplexity Pro per farsi citare?
No. L’inclusione in search la decidono OAI-SearchBot e PerplexityBot sul tuo robots.txt, non l’abbonamento di chi interroga. Plus e Pro cambiano il prodotto lato utente. Non sono un ticket di citazione per il tuo dominio.
Se blocco GPTBot sparisco da ChatGPT Search?
No. OpenAI tratta GPTBot e OAI-SearchBot come regole indipendenti. Chiudi GPTBot se non vuoi il training. Lascia aperto OAI-SearchBot se vuoi le search answers. Fonte: platform.openai.com/docs/bots.
llms.txt può sostituire una pagina ben scritta?
No. È una mappa opzionale. Sul mio sito c’è, è generica, e non ho un lift misurato. Se la pagina non risponde in 40-60 parole, il file non la salva.
Quante citazioni servono per dire che «funziona»?
Non ho una soglia universale. Io guardo il cambio di stato sul prompt di categoria, settimana su settimana. Un SoV su 18 prompt è un termometro interno, non un obiettivo di mercato.
Schema FAQPage fa entrare nelle risposte?
Non ho un paper che lo dimostri come leva di citazione. Lo uso come etichetta su domande già visibili, tipo FAQPage di schema.org. Se il markup non coincide col testo, è rumore.
Conviene ancora fare GEO su Reddit se ChatGPT non lo cita più?
Come scorciatoia per ChatGPT Search, no. Promptwatch (agosto 2026) misura la share Reddit in ChatGPT Search da circa 3,83% a 0,52%. Sul mio set italiano Reddit non era già la fonte dominante: vincevano micro-blog di categoria. Per GEO in Italia parti dalla pagina di categoria sul tuo sito, crawler aperti, dato con fonte. Su Perplexity Reddit resta più presente: non chiudere il canale ovunque, ricalibra l’aspettativa su ChatGPT.
Servire le pagine in markdown agli agenti AI sostituisce llms.txt?
No. llms.txt è un indice di URL. L’header Accept markdown serve la stessa pagina più pulita a certi agenti (Claude Code, Cursor). Non è il percorso di ChatGPT Search né di PerplexityBot, che leggono l’HTML pubblico. Io non ho un lift di citazioni da quel header. Parti dai crawler aperti e dal blocco di 40-60 parole.
Conviene creare in massa pagine «migliori software» per Perplexity?
No come scorciatoia. Trellner (2 settembre 2026) ha contato circa 215.128 pagine «best software» su siti nati dopo il 2023: Perplexity le pesca spesso. Sul mio set italiano vincono micro-blog con dato reale e crawler aperti, non le directory farm. Una pagina di categoria chiara batte cento liste generate.
Posso fidarmi dei numeri che Perplexity cita?
No come prova. Haus Research (2 settembre 2026): su 1.826 citazioni con un numero, circa il 34,7% punta a pagine senza quel dato o che non aprono. Se usi Perplexity per competitor o pricing, apri la fonte e cerca la cifra. Il marker [n] non è una verifica. Per farti citare: numeri tuoi con fonte in chiaro.
Serve anche llms-full.txt o basta llms.txt?
Per un blog di marketing basta llms.txt (indice). llms-full.txt è il corpus intero: utile in docs/RAG, non un ticket di citazione. Sul mio sito llms-full.txt è storicamente 404 (ricontrollato in edit day). Nel census Tranco top 5.000 del 7/09/2026, 55 siti su 373 con llms.txt valido pubblicano anche llms-full — spesso documentazione, non blog.
Conviene comprare Sponsored Agents su ChatGPT o basta AEO organico?
Sono due leve diverse. Sponsored Agents (annuncio OpenAI 16/09/2026) sono un formato ads in test con inserzionisti selezionati negli USA: dopo il click apri una chat etichettata col brand, separata dalle risposte indipendenti. Non comprano Share of Voice organico. In Italia hai Ads Manager self-service; gli Agents non sono ancora il prodotto da comprare qui. Io misuro SoV sui prompt come prima: ads ≠ AEO.
Il pixel di ChatGPT Ads fa aumentare le citazioni organiche?
No. Il Measurement Pixel e il cookie __obi servono a misurare le campagne ads (conversioni, consenso, eventuale CAPI), non a comprare una citazione organica né ad alzare lo Share of Voice. Sono due leve diverse: AEO e measurement. Il dettaglio operativo sta nella guida al ChatGPT Ads pixel.
Se faccio la landing con ChatGPT Sites, ChatGPT mi cita di più?
Non ho dati ufficiali che una landing su ChatGPT Sites venga citata di più. La guida OpenAI su Sites parla di creazione, hosting e dominio personalizzato, non di indicizzazione o di robots. L’11/11/2026 chatgpt.com/robots.txt blocca PerplexityBot e Google-Extended. Se ti serve una pagina citabile, pubblicala sul tuo dominio, con i crawler di search aperti.
Come escludo il sito dal training AI senza uscire dalle risposte di search?
Su OpenAI le due regole sono indipendenti. In robots.txt lasci aperto OAI-SearchBot se vuoi comparire in ChatGPT Search, e chiudi GPTBot se non vuoi il training dei foundation model. Fonte: documentazione crawler OpenAI, riletta l’11/11/2026. Un blocco largo su tutti i bot di training e search insieme è un altro mestiere, e ti può far uscire anche dalle risposte.
Come rivendicare la tua attività su ChatGPT (Business Hub)
Dal 10/11/2026 OpenAI ha aperto in beta Businesses in ChatGPT. Dal Business Hub rivendichi il profilo, aggiorni i dati e colleghi un feed prodotti. La verifica è telefono, email, TXT sul DNS o Shopify; la spunta blu arriva dopo Persona. Vedi menzioni, clic e temi di scoperta su 28 giorni. Rivendicare non alza la visibilità.
Questa sezione ripete le pagine ufficiali rilette l’11/11/2026. Non ho rivendicato un profilo né fatto lo screenshot di un account: la verifica d’identità è un passo a parte e non entra in questa pagina.
- Apri ChatGPT, vai su Business Hub nella barra laterale e cerca l’attività per nome. Se non la trovi e hai un’attività online idonea, può comparire l’opzione per aggiungerla.
- Scegli un metodo di verifica tra quelli proposti: telefono, email aziendale, record TXT nel DNS del dominio, oppure collegamento del negozio Shopify.
- Aspetta l’esito della rivendicazione (OpenAI la comunica via email). Poi completa il controllo identità con Persona: senza questa approvazione non pubblichi modifiche, non vedi gli insight e non crei un eventuale agente. La spunta blu arriva dopo Persona, non con la sola rivendicazione.
- Se vendi prodotti, collega un feed: file CSV secondo la specifica, URL del feed, oppure feed Shopify. Collegare il feed non pubblica un agente e non garantisce che ChatGPT raccomandi i tuoi prodotti.
Cosa vedi negli insight, in aggregato sugli ultimi 28 giorni: menzioni (per un’attività online conta il riferimento al sito, non il solo nome del brand), clic verso il sito, e «discovery topics» (temi ricorrenti, non i prompt singoli). OpenAI non condivide le conversazioni. Una metrica vuota può voler dire soglia non raggiunta, non necessariamente zero. Fonte: annuncio OpenAI del 10/11/2026 e guida di setup.
I limiti onesti, così come stanno scritti nelle pagine ufficiali: rivendicare il profilo non aumenta la visibilità e non ti dà controllo sulle risposte indipendenti di ChatGPT. Il Business Agent (chat col cliente sul profilo) è riservato ad attività e-commerce e servizi online negli Stati Uniti. I negozi e i ristoranti locali, oggi, possono rivendicare solo una scheda già esistente negli USA. L’idoneità dipende da luogo e tipo di attività: un sito italiano online può vedere l’opzione per aggiungere il profilo, ma la pagina ufficiale non pubblica una lista paese per paese.
Come rendere il negozio trovabile dagli agenti AI che comprano
Per farti trovare dagli agenti AI che comprano, su Shopify usi il Catalog e la knowledge base su resi, spedizioni e pagamenti. Al 11/11/2026 l’acquisto sulle vetrine agentiche, secondo Shopify, è solo per acquirenti negli Stati Uniti. Un negozio italiano può essere scoperto se vende a quei buyer; il checkout Italia-Italia ancora no.
Nella pratica, sul piano ufficiale di Shopify, tieni in ordine tre pezzi. Il Catalog è il canale con cui i prodotti arrivano a ChatGPT, Copilot, AI Mode/Gemini e Meta, se sei idoneo. La knowledge base è il testo non di prodotto che gli agenti leggono: resi, tempi di spedizione, pagamenti, valori del brand. Shop Pay può comparire nel checkout degli agenti personali dove è supportato; non devi attivarlo apposta per gli agenti. Non ho un negozio Shopify di test: qui non trovi screenshot del backend.
Cosa arriva all’Italia oggi, secondo l’pagina ufficiale di Shopify sull’agentic commerce (11/11/2026): l’acquisto su tutti i canali agentici è per acquirenti negli Stati Uniti. ChatGPT è già live per i merchant che vendono a quei buyer, anche se il negozio sta altrove; l’acquisto si chiude sul checkout del tuo store (browser in-app o nuova scheda). Copilot Checkout segue la stessa logica sui merchant del Catalog che vendono agli USA. Il checkout diretto in AI Mode e Gemini è limitato a negozi selezionati con sede negli USA che vendono ad acquirenti USA. Quando i partner apriranno altre aree, Shopify dice che i merchant saranno già pronti di default.
Come lo misuri, senza inventare un effetto AEO: le vetrine agentiche di Shopify hanno insight di ricerca e vendita nel admin; le citazioni organiche le misuri ancora con il set di prompt e, per Copilot/Bing, con AI Performance. Entrare nel Catalog non è una citazione su ChatGPT Search. Sono due binari.
Cosa fai dopo aver letto questo playbook
Tu fai tre cose, in ordine, e poi misuri. Apri robots.txt e verifica OAI-SearchBot, PerplexityBot e il WAF. Riscrivi l’apertura della pagina di categoria in 40-60 parole con un dato tuo, datato. Lancia 5-8 prompt italiani e segna i tre stati. llms.txt e schema vengono dopo.
Il 12 agosto 2026 questo sito era assente sui prompt AEO, con SoV 11,1% su 18 prompt, citato su Perplexity solo a brand. I competitor erano micro-blog. Il buco si chiude con una pagina, non con una teoria. Il metodo in 5 passi resta nella guida AEO in 5 passi. Questa URL è il playbook citazioni.
Se misuri ads in ChatGPT, leggi anche la guida sul ChatGPT Ads pixel e sul cookie __obi: cosa traccia il Measurement Pixel, come gestirlo sotto consenso ADV in Italia e quando conviene la sola CAPI.
Esempio di query che ChatGPT risponde citando ISTAT/Osservatori/Confindustria: quante aziende italiane usano l’AI nel marketing — pagina costruita per essere citabile.
Su Google Search il pezzo paid è un altro gioco: quando l’AI Overview sta in cima alla SERP, il framework Fight / Influence / Generate demand per AI Overview e Google Ads spiega dove ha senso comprare absolute top e dove invece conti la citazione (senza overpayare CPC).
