Aggiornato il 16 novembre 2026
Alibaba ha rilasciato Qwen4-Max il 16 novembre 2026, alle 03:01 ora italiana, con un post sul blog ufficiale Qwen e un annuncio su X. Qui trovi prezzi verificati oggi, cosa cambia rispetto a 3.8 e un test vero su un brief marketing.
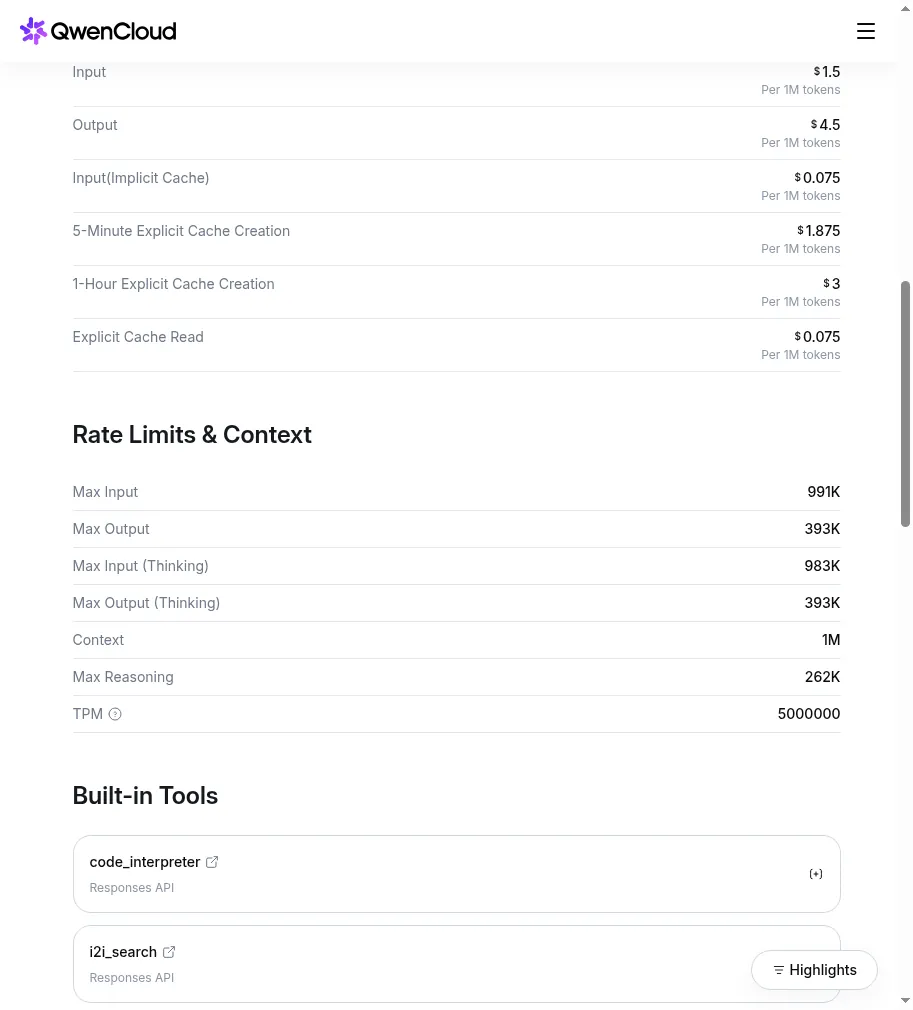
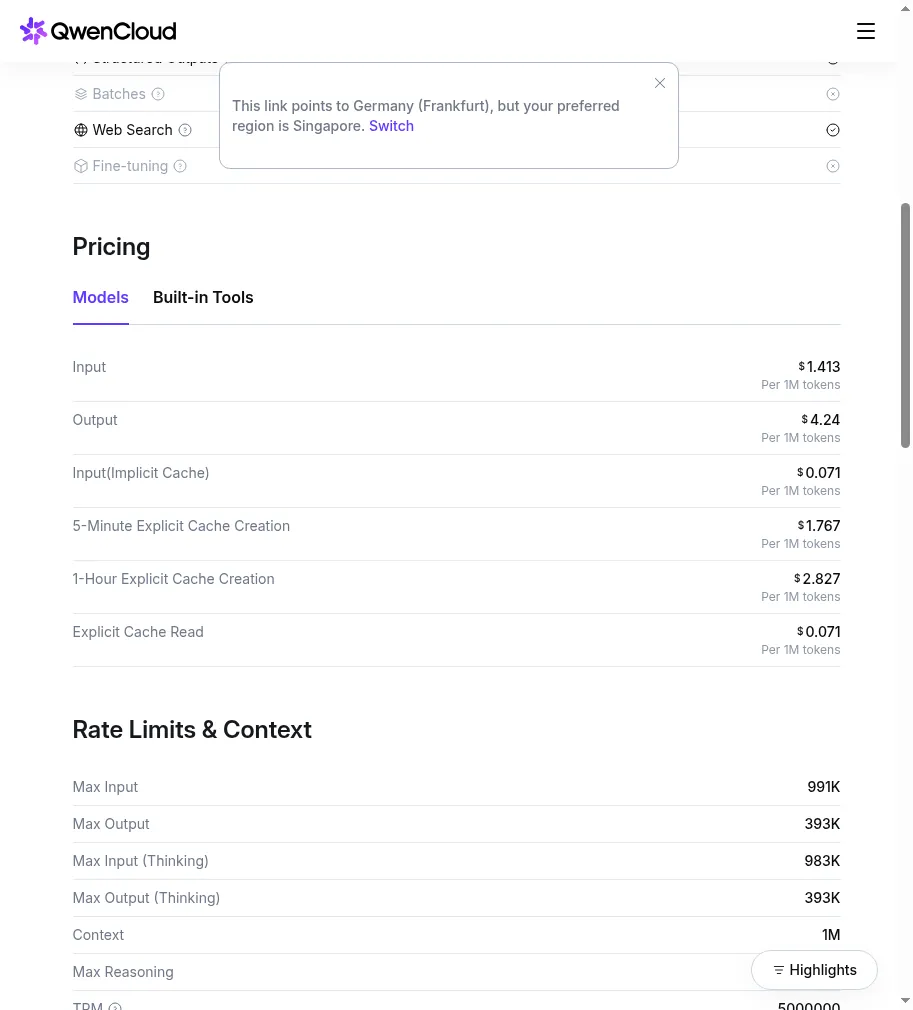
Qwen 4 Max (nome API qwen4-max) è il nuovo modello di punta di Alibaba. È un MoE da 2,4 trilioni di parametri, con 71 miliardi attivi per token, visione nativa e un contesto da 1 milione di token. In API su QwenCloud costa $1,50 per milione di token in input e $4,50 in output nella regione Singapore, $1,413 e $4,24 nella regione di Francoforte.
Rispetto a Qwen 3.8 Max il listino di Singapore scende del 25% su input e output e del 70% sull’input in cache.
Non è open source, la pagina ufficiale non indica una quota gratuita e su Qwen Studio senza login, oggi, non compare. Io non ho trovato un accesso gratuito a 4 Max, quindi ho passato lo stesso brief marketing a Qwen 3.8 Max e ti do il costo di 4 Max stimato sugli stessi token. Te lo dico subito: è una stima, non un output.
Cosa serve sapere in 30 secondi
- Uscita: 16/11/2026. Alibaba lo presenta come un «teammate» per lavoro d’ufficio, coding e agenti che girano per ore.
- Prezzo API: $1,50 input e $4,50 output per milione di token a Singapore, $1,413 e $4,24 a Francoforte. L’input in cache implicita costa $0,075, il 95% in meno.
- Limiti: contesto da 1 milione di token, input massimo 991.000, output massimo 393.000. Qwen 3.8 Max si ferma a 131.000 in output.
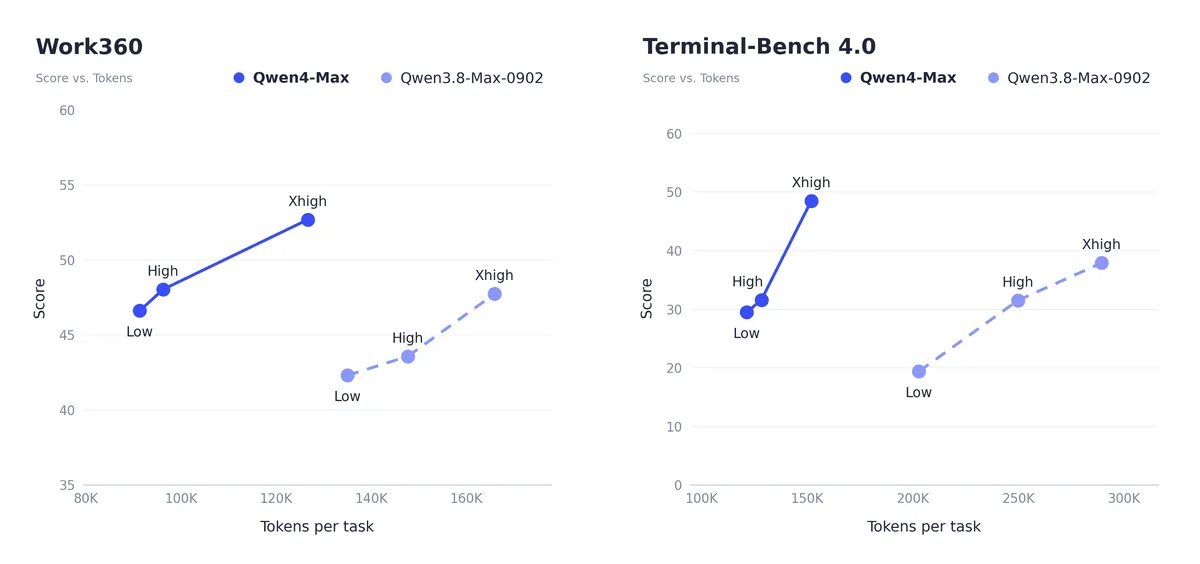
- Benchmark: sul test interno Work360 Alibaba dichiara 52,69 contro 47,74 di 3.8 Max. Artificial Analysis, che è indipendente, gli dà 43 sul suo indice, sopra la mediana di 41 della sua fascia di prezzo.
- Gratis: nessuna quota gratuita sulla pagina vendor. Alibaba dice che è su Qwen Studio, ma senza account vedi solo Qwen3.7-Plus e Qwen3.8-Max.
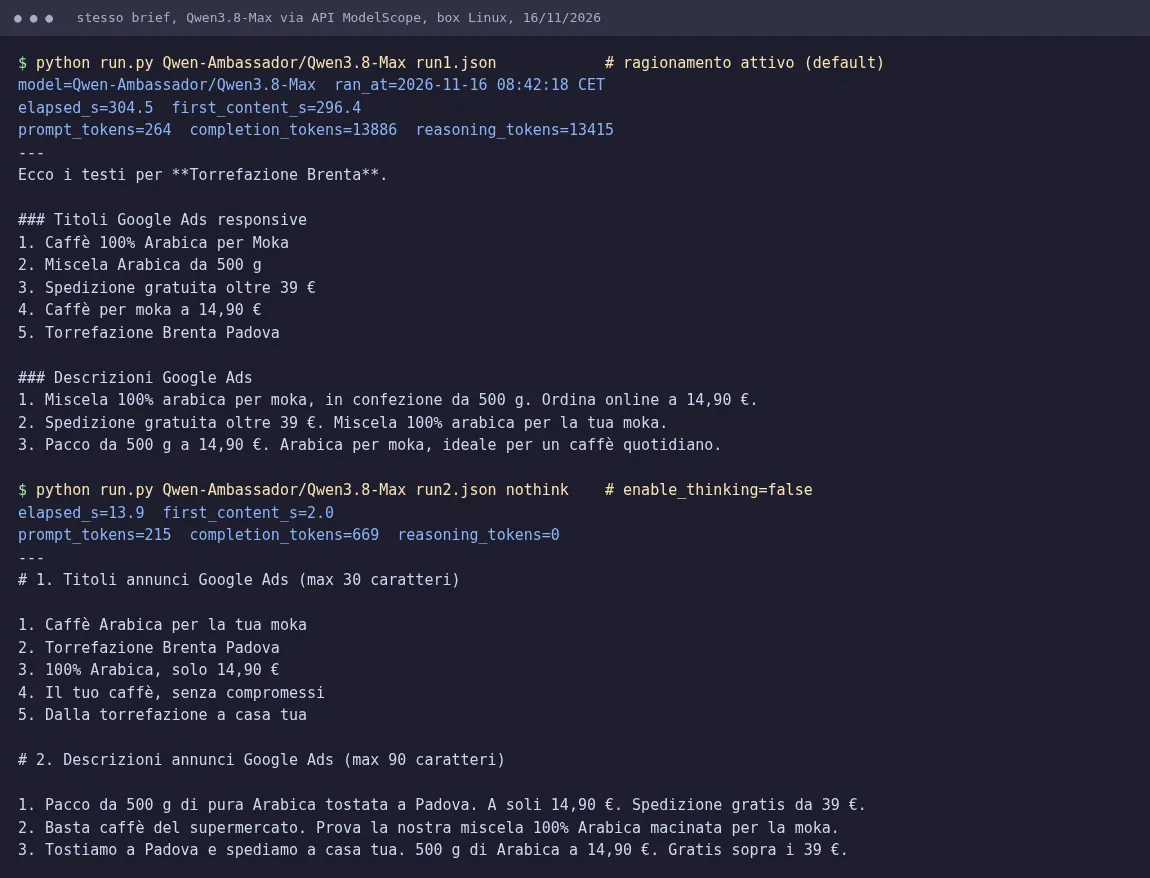
- Il mio test su 3.8 Max: con il ragionamento attivo, 5 minuti e tutti i limiti di caratteri rispettati. Senza ragionamento, 14 secondi e due limiti sforati.
Trasparenza prima di tutto: sono ambassador Qwen. Per il test ho usato l’accesso ambassador all’API di ModelScope, che per me è gratuito. Prezzi e benchmark vengono dalle pagine ufficiali, linkate dove li cito.
Cos’è Qwen 4 Max e cosa cambia rispetto a Qwen 3.8?
Qwen 4 Max è il primo modello della famiglia Qwen4. Tiene la taglia di Qwen 3.8 Max, 2,4 trilioni di parametri, ma ne attiva 71 miliardi per token invece di 95. Cambia l’architettura, sale l’output massimo da 131.000 a 393.000 token e scende il prezzo, ma i pesi non sono pubblici.
Le novità tecniche, dal blog ufficiale, sono tre. Un’attenzione nuova, Qwen Sparse Attention, affiancata da strati Gated DeltaNet che comprimono la storia della conversazione. Poi quattro rami residui con «cancelli» dinamici e un modulo N-gram Embedding da 328 miliardi di parametri in più.
A te, come marketer, interessano due effetti. Alibaba dichiara che 4 Max usa meno token di 3.8 Max per lo stesso lavoro: circa il 24% e il 35% in meno su Work360, a seconda dello sforzo di ragionamento. E il costo medio per task, nel loro test, passa da $4,43 a $1,67.
| Voce | Qwen 3.8 Max | Qwen 4 Max |
|---|---|---|
| Parametri totali | 2,4 trilioni | 2,4 trilioni |
| Parametri attivi per token | 95 miliardi | 71 miliardi |
| Contesto | 1 milione di token | 1 milione di token |
| Output massimo | 131.000 token | 393.000 token |
| Input, Singapore | $2 per milione | $1,50 per milione |
| Output, Singapore | $6 per milione | $4,50 per milione |
| Input in cache implicita, Singapore | $0,25 per milione | $0,075 per milione |
| Input e output, Francoforte | $1,65 e $4,951 | $1,413 e $4,24 |
| Pesi aperti | Sì, come Qwen3.8-2.4T-A95B | No |
Fonti della tabella, aperte oggi: pagine QwenCloud di Qwen4-Max e Qwen3.8-Max, con il selettore di regione su Singapore e su Germania (Francoforte). I parametri attivi di 3.8 Max vengono dal nome dei pesi aperti, A95B.
Quanto costa Qwen 4 Max in API?
Qwen 4 Max costa $1,50 per milione di token in input e $4,50 per milione in output sulla regione Singapore di QwenCloud. A Francoforte il listino è più basso, $1,413 e $4,24, sempre a consumo e in dollari. Il ragionamento è attivo di default e, nell’usage dell’API, i suoi token rientrano tra quelli in output.
Qui sotto trovi tutte le voci del listino, regione per regione. La cache conta più di quanto sembri: se mandi sempre le stesse linee guida di brand in testa al prompt, quella parte ti costa una frazione.
| Voce di prezzo (per milione di token) | Singapore | Germania (Francoforte) |
|---|---|---|
| Input | $1,50 | $1,413 |
| Output | $4,50 | $4,24 |
| Input in cache implicita | $0,075 | $0,071 |
| Creazione cache esplicita, 5 minuti | $1,875 | $1,767 |
| Creazione cache esplicita, 1 ora | $3 | $2,827 |
| Lettura cache esplicita | $0,075 | $0,071 |
Fonte: pagina ufficiale di Qwen4-Max su QwenCloud, letta il 16/11/2026 con regione Singapore e poi Germania. Lo stesso prezzo di Singapore lo applica OpenRouter, che oggi ha un solo fornitore, Alibaba Cloud International.
Perché Francoforte ti interessa
Per un’agenzia italiana Francoforte ha due vantaggi. Costa circa il 6% in meno e tiene le richieste in una regione europea, cosa che ti semplifica il discorso con il cliente sui dati. Per la parte legale chiedi comunque al tuo DPO: io qui ti do solo il listino.
Qwen 4 Max è gratis? Dove lo provi senza pagare?
Oggi Qwen 4 Max non ha un accesso gratuito che io abbia potuto verificare. La pagina QwenCloud mostra solo prezzi a consumo, senza quota gratuita, e il blog ufficiale dice che il modello è anche su Qwen Studio, QwenWork e Qoder. Ma su Qwen Studio, senza login, il menu dei modelli oggi offre solo Qwen3.7-Plus e Qwen3.8-Max.
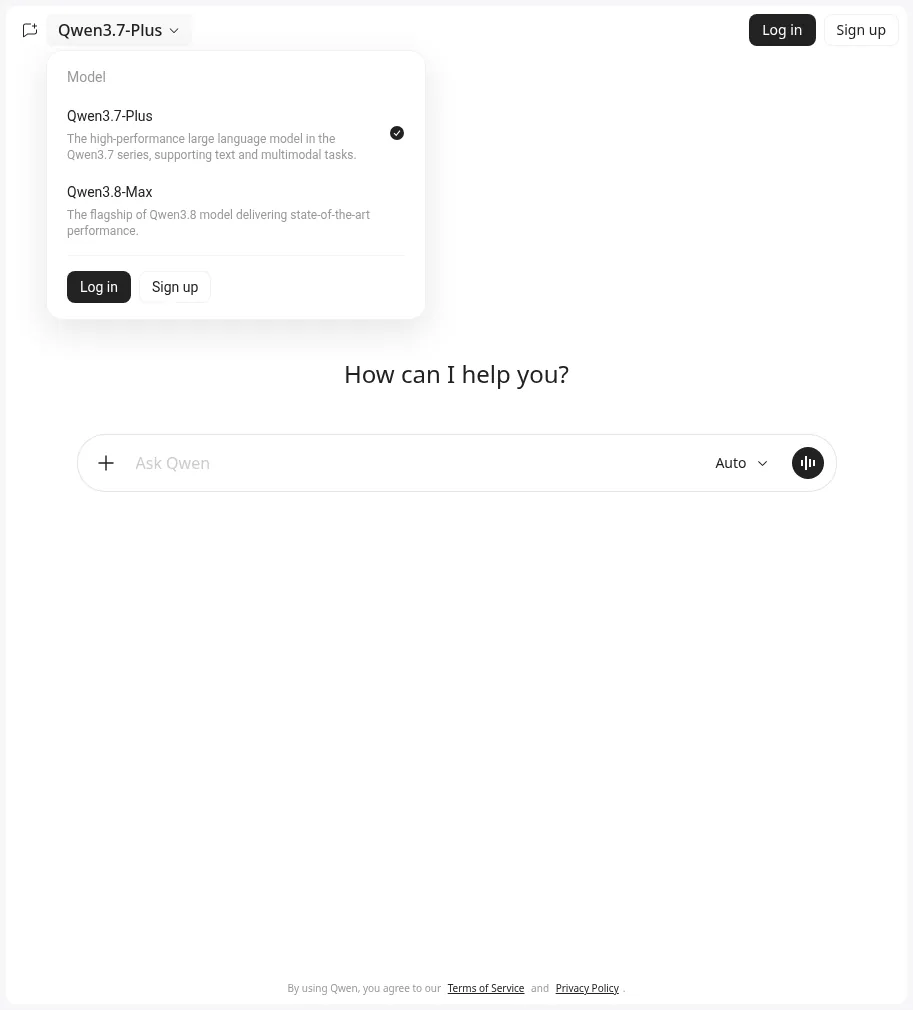
Con un account Qwen Studio potrebbe comparire. Io non mi sono loggato, quindi non te lo confermo. Se lo provi tu, guarda il menu in alto a sinistra: il nome da cercare è Qwen4-Max.
Le altre strade gratis che conosco non portano a 4 Max:
- Pesi aperti: non ci sono. Artificial Analysis lo classifica come modello proprietario e Alibaba non li ha annunciati per Max.
- Modelli Qwen4 piccoli: il blog dice che arriveranno in open source, senza una data. Qwen4-27B, di cui si parla molto su X, non è ancora uscito.
- ModelScope: l’elenco dei modelli che vedo con il mio accesso ambassador, 36 in tutto, oggi non contiene nessun Qwen4.
- Qwen 3.8 Max: resta selezionabile su Qwen Studio. Per provare il salto di qualità ti serve comunque 4 Max.
Come va lo stesso brief marketing su Qwen 3.8 Max? L’ho testato
Ho passato lo stesso brief a Qwen 3.8 Max due volte via API, il 16/11/2026 tra le 08:37 e le 08:44: una volta con il ragionamento attivo, una senza. Con il ragionamento ha rispettato tutti i limiti di Google Ads ma ci ha messo 5 minuti. Senza, 14 secondi e due righe troppo lunghe.
Il brief è quello di un caso tipico da e-commerce italiano: annunci Google Ads responsive con limiti di caratteri rigidi, più una email di lancio. È il genere di lavoro dove un modello sbaglia spesso di un carattere e te ne accorgi solo quando Google Ads rifiuta il titolo. Copialo e usalo per il tuo confronto.
Sei il copywriter di un piccolo e-commerce italiano di caffè in grani, "Torrefazione Brenta" (Padova). Lanciamo una miscela 100% arabica per moka a 14,90 euro il pacco da 500 g, con spedizione gratuita sopra i 39 euro. Pubblico: persone tra 30 e 55 anni che oggi comprano caffè al supermercato.

Consegna, in italiano, dando del tu:
1. 5 titoli per annunci Google Ads responsive, ciascuno di massimo 30 caratteri spazi inclusi.
2. 3 descrizioni Google Ads, ciascuna di massimo 90 caratteri spazi inclusi.
3. Un oggetto email di massimo 45 caratteri e un testo email di circa 120 parole.
Non inventare recensioni, premi o percentuali. Alla fine scrivi tra parentesi il numero di caratteri di ogni titolo e descrizione.
Poi ho ricontato io ogni titolo e ogni descrizione con uno script, perché il conteggio che il modello scrive in fondo non è una prova.
Cosa è andato e cosa no
| Modalità | Tempo totale | Prima parola dopo | Token in output | Limiti di caratteri rispettati | Errori nel contenuto |
|---|---|---|---|---|---|
| Ragionamento attivo | 304,5 secondi | 296,4 secondi | 13.886, di cui 13.415 di ragionamento | 8 su 8, email di 120 parole | Nessuno rispetto al brief |
| Senza ragionamento | 13,9 secondi | 2,0 secondi | 669 | 6 su 8: un titolo da 31 caratteri, una descrizione da 91 | Scrive «macinata per la moka», ma il caffè è in grani |
Il dettaglio che mi ha colpito: senza ragionamento il modello dichiara 30 e 90 caratteri anche per le due righe che sforano. Se incolli il suo conteggio senza controllarlo, Google Ads ti rifiuta l’annuncio.
Con il ragionamento attivo i testi sono corretti ma piatti. Titoli come «Caffè per moka a 14,90 €» funzionano, però li scriveresti anche tu in due minuti. La versione veloce osa di più, con «Basta caffè del supermercato», ma sbaglia i fatti.
Quanto sarebbe costato a listino
A me il test è costato zero, per via dell’accesso ambassador. Ecco quanto costerebbe a listino QwenCloud con gli stessi token, per un brief e per mille brief. Per 4 Max è una stima: uso i token misurati su 3.8 Max, e Alibaba dichiara che 4 Max ne usa meno.
| Scenario | 3.8 Max Singapore | 3.8 Max Francoforte | 4 Max Singapore, stima | 4 Max Francoforte, stima |
|---|---|---|---|---|
| Un brief, ragionamento attivo | $0,0838 | $0,0692 | $0,0629 | $0,0592 |
| Mille brief, ragionamento attivo | $83,84 | $69,19 | $62,88 | $59,25 |
| Un brief, senza ragionamento | $0,0044 | $0,0037 | $0,0033 | $0,0031 |
| Mille brief, senza ragionamento | $4,44 | $3,67 | $3,33 | $3,14 |
Il calcolo è token in input per prezzo di input più token in output per prezzo di output, con i listini della tabella sopra. Il ragionamento pesa: con lo stesso modello passi da mezzo centesimo a otto centesimi per brief.
Cosa non ho testato
Qwen 4 Max non l’ho fatto girare. Non era tra i modelli del mio accesso ModelScope, la key QwenCloud che uso per i test oggi non lo elenca e su Qwen Studio senza login non c’è. Pagarlo a consumo era possibile, ma per questi test la regola è spesa zero: appena ho accesso, rifaccio lo stesso brief e aggiorno questa pagina.
Quali benchmark dichiara Alibaba, e quanto fidarsi?
Alibaba dichiara che Qwen 4 Max batte Qwen 3.8 Max su quasi tutti i test che ha pubblicato. Su Work360, il suo benchmark di lavoro professionale, passa da 47,74 a 52,69. Sono numeri del produttore, e l’unico indice indipendente uscito oggi, quello di Artificial Analysis, lo mette a 43, sopra la mediana della sua fascia.
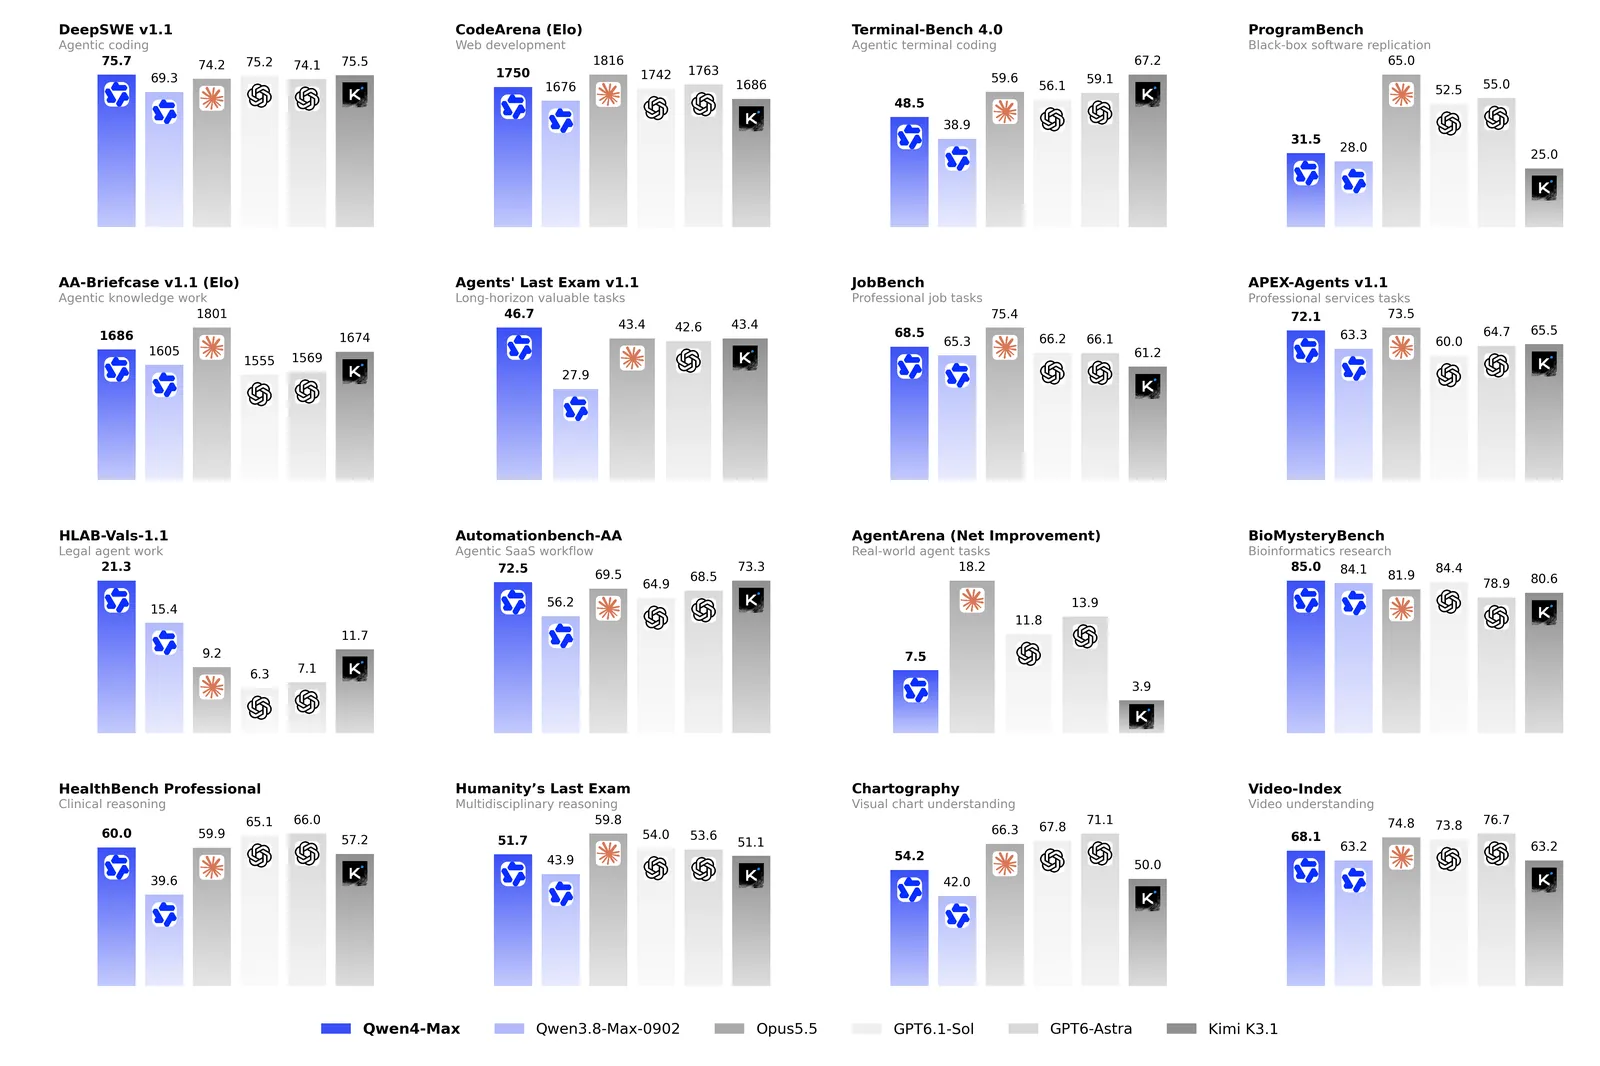
Ho trascritto dal grafico ufficiale i valori più utili per chi fa marketing. Accanto metto il modello che vince su quel test, perché Qwen 4 Max non è primo dappertutto.
| Benchmark | Cosa misura | Qwen 4 Max | Qwen 3.8 Max (0902) | Chi vince nel grafico |
|---|---|---|---|---|
| Work360 | Lavoro professionale in 26 settori | 52,69 | 47,74 | Dato solo per i due Qwen |
| JobBench | Compiti di lavoro reali | 68,5 | 65,3 | Opus 5.5, 75,4 |
| AA-Briefcase v1.1 | Lavoro d’ufficio con documenti, in Elo | 1.686 | 1.605 | Opus 5.5, 1.801 |
| CodeArena | Sviluppo web, in Elo | 1.750 | 1.676 | Opus 5.5, 1.816 |
| Chartography | Lettura di grafici | 54,2 | 42,0 | GPT6-Astra, 71,1 |
| Video-Index | Comprensione video | 68,1 | 63,2 | GPT6-Astra, 76,7 |
Fonte: grafico «Comprehensive performance comparison» nel blog ufficiale Qwen4-Max. I valori di Work360 sono nel testo dello stesso post.
Cosa dicono le fonti indipendenti
Artificial Analysis dà a Qwen 4 Max 43 punti sul suo Intelligence Index, 38° su 81 modelli confrontabili. Costa $3,27 per task del loro indice ed è prolisso: 127 milioni di token in output contro una mediana di 78,6 milioni.
Su OpenRouter oggi la velocità mediana è di 36 token al secondo. Nel thread di Hacker News del lancio, uno sviluppatore si lamentava proprio della lentezza di Qwen 3.8. Il mio test lo conferma: cinque minuti di attesa per un brief corto.
Per quali lavori di marketing ha senso Qwen 4 Max?
Qwen 4 Max ha senso dove servono tanto contesto, immagini in input e output lunghi, a un prezzo per token più basso dei flagship americani di fascia alta. Per un annuncio da 30 caratteri è sprecato. Per un brand book più cinquanta annunci da riscrivere in una sola richiesta, il milione di token di contesto fa la differenza.
Questi sono i lavori dove lo proverei per primo, in ordine di guadagno atteso:
- Documenti lunghi in un colpo: report di settore, brand book, trascrizioni di interviste. L’input arriva a 991.000 token.
- Screenshot di campagne e dashboard: la pagina vendor elenca testo, immagini e video in input. Gli passi lo screenshot di una campagna e chiedi cosa non torna.
- Testi lunghi in uscita: con 393.000 token di output massimo puoi chiedere un intero set di schede prodotto in una sola risposta.
- Linee guida ripetute: metti tono di voce e regole di brand sempre in testa al prompt. Con la cache implicita quella parte costa $0,075 per milione invece di $1,50.
- Ricerche con fonti fresche: Web Search è segnato come disponibile, quindi puoi chiedere un riepilogo dei competitor con dati di oggi. Batches e fine-tuning, invece, la pagina vendor li segna come non disponibili per questo modello.
Per i feed e gli annunci in blocco ti conviene chiedere un JSON con uno schema fisso. Qwen 4 Max supporta gli Structured Outputs. Questo è il prompt che uso come base:
Rispondi solo con un JSON valido, senza testo prima o dopo.
Schema: {"titoli": [5 stringhe di massimo 30 caratteri], "descrizioni": [3 stringhe di massimo 90 caratteri]}
Prodotto: [nome, prezzo, punto di forza]
Pubblico: [chi compra e cosa usa oggi]
Vietato: recensioni, premi, percentuali o claim non presenti nel brief.
Anche con il JSON, ricontrolla i caratteri con uno script. Il mio test su 3.8 Max dice che il conteggio del modello non basta.
Qwen 4 Max o Qwen 3.8 Max: quale usi oggi?
Se usi già Qwen in API, passa a Qwen 4 Max: a listino costa meno di 3.8 Max e cambi solo il nome del modello nella chiamata. Resta su Qwen 3.8 se ti servono i pesi aperti, per esempio il 27B in locale sui dati del cliente. Per 4 Max i pesi non ci sono.
Le regole che seguirei, caso per caso:
- Hai già codice su qwen3.8-max: prova
qwen4-maxsullo stesso set di prompt e confronta qualità e token spesi prima di cambiare in produzione. - Lavori su dati che non devono uscire: resta sui pesi aperti di 3.8. Trovi requisiti e limiti nella recensione di Qwen 3.8.
- Usi ChatGPT, Claude o Gemini: Qwen 4 Max è un’alternativa più economica in API, non un’app da usare tutti i giorni come quelle. Per il confronto tra le tre app parti dal confronto tra ChatGPT, Claude e Gemini.
- Cerchi un modello cinese da far girare in locale: oggi guarda Qwen 3.8 27B o Kimi. Per Kimi c’è la guida a Kimi AI con Ollama.
Per il quadro completo dei chatbot, dalle app ai prezzi, resta valida la nostra guida all’intelligenza artificiale.
Come provi Qwen 4 Max in API in 4 passi?
Ti servono un account QwenCloud, una API key e credito a consumo, perché in pagina non c’è una quota gratuita. L’API è compatibile con quella di OpenAI e con quella di Anthropic, quindi puoi usare gli SDK che hai già. Questi sono i passi che seguirei io:
- Crea un account su QwenCloud e scegli la regione. Per i prezzi più bassi e i dati in Europa, Germania (Francoforte).
- Genera una API key in console e copia l’URL base della tua regione. Quello di Singapore è nell’esempio qui sotto.
- Salva la key come variabile d’ambiente, con il comando che trovi sotto.
- Lancia una prima chiamata breve con il ragionamento spento, poi la stessa con il ragionamento attivo, e confronta tempi e token.
Salva la key nel terminale:
export DASHSCOPE_API_KEY="la-tua-key"Poi fai la prima chiamata, con lo stesso formato dell’API OpenAI:
curl https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1/chat/completions -H "Authorization: Bearer $DASHSCOPE_API_KEY" -H "Content-Type: application/json" -d '{"model": "qwen4-max", "messages": [{"role": "user", "content": "Scrivi 5 titoli Google Ads di massimo 30 caratteri per una torrefazione di Padova"}], "enable_thinking": false}'Nella risposta guarda il campo usage: lì trovi i token in input e in output, cioè quelli che paghi. Moltiplicali per il listino e sai quanto ti costa ogni brief.
Domande frequenti su Qwen 4 Max
Qwen 4 Max è gratis?
Non c’è una quota gratuita sulla pagina QwenCloud al 16/11/2026. Alibaba dice che il modello è su Qwen Studio, ma senza account oggi vedi solo Qwen3.7-Plus e Qwen3.8-Max. In API si paga a consumo: $1,50 e $4,50 per milione di token a Singapore.
Qwen 4 Max è open source?
No: i pesi di Qwen 4 Max non sono pubblici e Artificial Analysis lo classifica come proprietario. Alibaba ha annunciato modelli Qwen4 più piccoli in open source, senza data. Del 27B si parla molto su X, ma non è uscito.
Quanto contesto ha Qwen 4 Max?
Un milione di token, con input massimo di 991.000 token e output massimo di 393.000. In modalità ragionamento l’input scende a 983.000 e il ragionamento arriva a 262.000 token.
Posso usarlo con le API di OpenAI?
Sì. QwenCloud lo dichiara compatibile con le API di OpenAI e di Anthropic. Con l’SDK OpenAI cambi URL base, API key e nome del modello, che è qwen4-max.
Quando escono Qwen4-27B e gli altri modelli piccoli?
Il blog ufficiale dice solo che i modelli più piccoli della famiglia arriveranno in open source. Al 16/11/2026 non c’è una data. Fino ad allora, per un modello Qwen in locale resta Qwen 3.8 27B.
Cosa cambia nel tuo lavoro questa settimana?
Se paghi già un modello in API per testi lunghi, analisi di documenti o annunci in blocco, Qwen 4 Max merita un test da pochi dollari. Il listino è più basso di 3.8 Max, la regione di Francoforte costa ancora meno e il contesto da un milione di token ti fa mandare il brand book intero.
Se usi solo l’app di ChatGPT o di Claude, per ora niente: 4 Max non ha un accesso gratuito verificato e su Qwen Studio senza account non c’è.
Una cosa la porterei a casa dal mio test, a prescindere dal modello. Il ragionamento attivo rispetta i limiti di Google Ads, quello spento no, e costa circa 19 volte di meno. Scegli in base al lavoro, e ricontrolla sempre i caratteri con uno script.
Se vuoi partire con prompt già pronti per annunci, email e articoli, scarica i nostri prompt AI gratis.
Il verdetto per oggi: Qwen 4 Max è il Qwen che userei in API, ma finché non lo provo sullo stesso brief non ti dico che scrive meglio di 3.8.
