Aggiornato il 29/09/2026
Codice invito Grok
Prova Grok Bot con il mio codice.
Registrati con il codice qui sotto: è lo stesso strumento che uso per gli agenti e le automazioni di cui scrivo.
J8KPF9435DHW
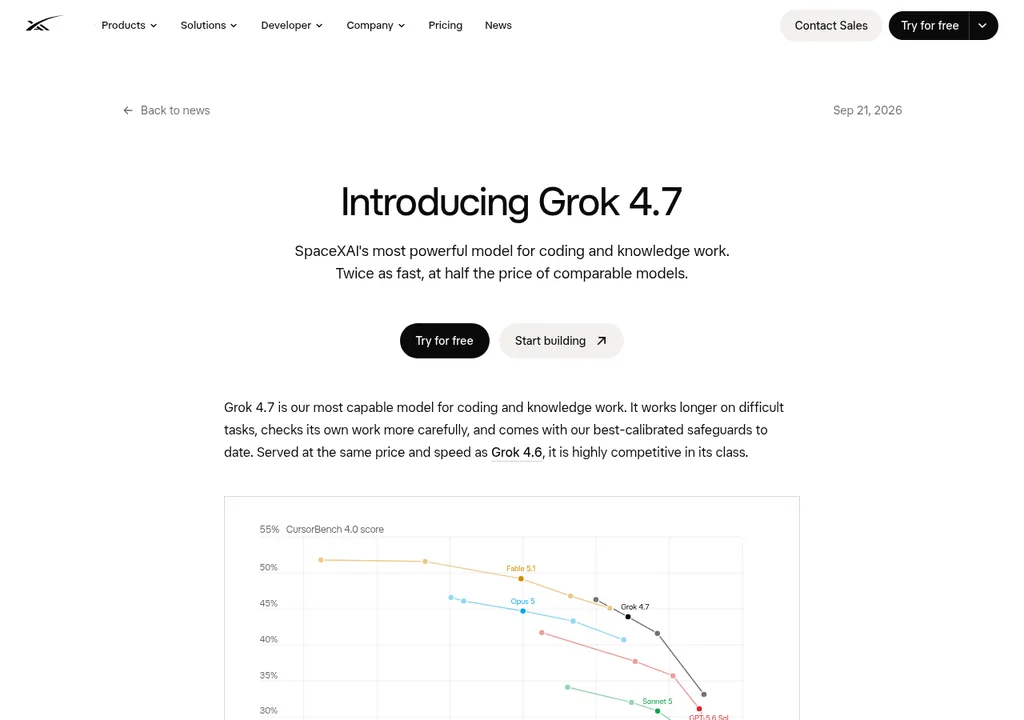
Grok 4.7 è il nuovo modello di punta di SpaceXAI (ex xAI), uscito il 21 settembre 2026. Costa esattamente come Grok 4.6: $2 per milione di token in input e $6 in output sotto i 200.000 token di prompt, con 500.000 token di contesto. Rispetto a 4.6 usa un modello base più grande, lavora meglio sui compiti lunghi, controlla di più il proprio lavoro e produce documenti e presentazioni migliori. xAI lo ha anche addestrato a capire in modo nativo l’harness di Grok Bot. Lo trovi in Cursor, in Grok Build e nell’API come grok-4.7. Per chi fa marketing la scelta è netta: se lo selezioni tu, cioè in API, Cursor o Grok Build, passa a 4.7 per brief lunghi, deck e research, perché a parità di prezzo non c’è motivo di restare su 4.6. Sul copy finale in italiano, invece, fai prima un test tuo. Qui trovi prezzi verificati oggi, confronto con Fable 5.1, il mio test in Cursor e cosa cambia davvero dentro Grok Bot.
Cosa devi sapere su Grok 4.7 in 30 secondi?
Grok 4.7 è l’aggiornamento di Grok 4.6 allo stesso prezzo: più bravo su lavori lunghi, documenti e deck, con un contesto da 500.000 token. Per il marketing conta perché abbassa il costo dei task lunghi senza cambiare il budget. Ecco i sei punti da tenere a mente.
- Uscita: 21/09/2026, annunciato da SpaceXAI come il suo modello più capace per coding e knowledge work (annuncio ufficiale).
- Prezzo API: $2 input / $6 output per milione di token, input in cache $0,50. Sopra i 200.000 token di prompt si passa a $4 / $12 su tutta la richiesta.
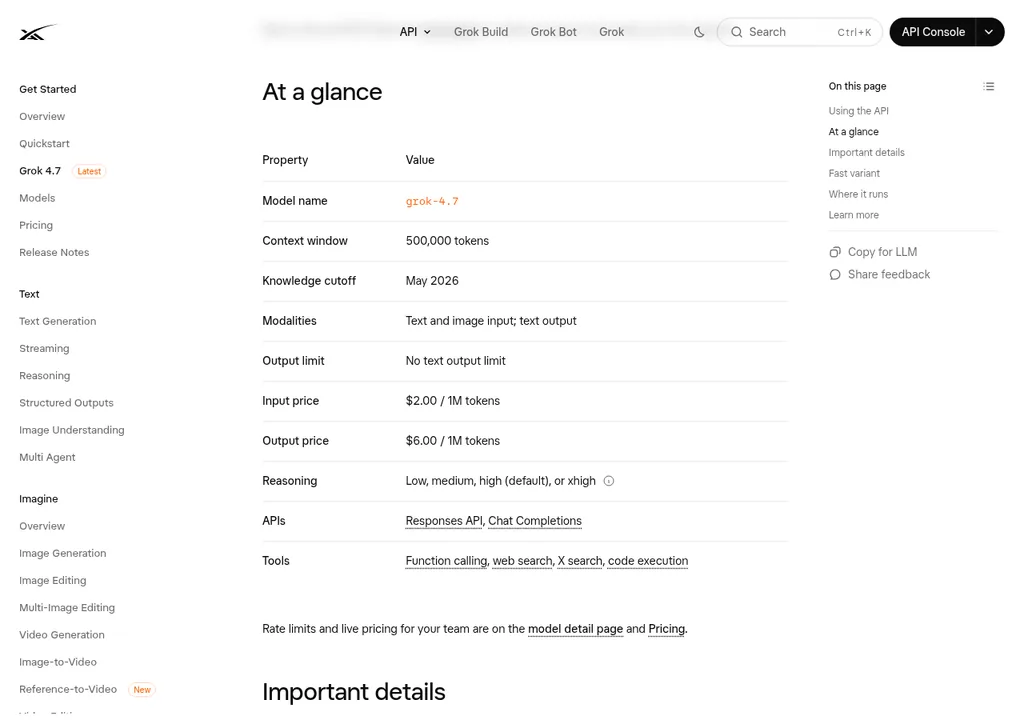
- Contesto e dati: 500.000 token di finestra, knowledge cutoff maggio 2026, input testo e immagini, output solo testo.
- Dove gira: Cursor, Grok Build (dove è il modello di default), API xAI e gateway come OpenRouter, Vercel e Cloudflare.
- Grok Bot: xAI l’ha addestrato sull’harness di Grok Bot, ma nell’app non esiste un selettore del modello. La scelta la fa Cursor.
- Contro Fable 5.1: Fable resta avanti di poco sui benchmark di lavoro d’ufficio, ma costa 5 volte tanto in input e oltre 8 volte in output.
Cos’è Grok 4.7 e cosa cambia rispetto a Grok 4.6?
Grok 4.7 è un modello linguistico di SpaceXAI costruito su un modello base nuovo e più grande di Grok 4.6. È stato allenato con una fase di reinforcement learning più lunga, su compiti che richiedono molte ore di lavoro. Il risultato dichiarato: verifica meglio il proprio output, gestisce meglio i contesti lunghi e costa uguale.
Un modello base è la rete di partenza, quella che poi viene rifinita con l’addestramento specifico. Cambiarlo è un salto più grosso di un normale aggiornamento, e si vede nei numeri che xAI pubblica.
Le novità che contano per te, in ordine di impatto sul lavoro di marketing:
- Task lunghi. L’addestramento è pesato su problemi che richiedono ore. Tradotto: research competitor, brief completi, piani editoriali che toccano più fonti.
- Autocontrollo. xAI scrive che il modello «controlla il proprio lavoro con più attenzione». Su un brief significa meno numeri inventati da correggere dopo, almeno sulla carta.
- Documenti e presentazioni. È l’unico miglioramento che l’annuncio lega in modo esplicito a deck e documenti, misurato su GDPval e AA Briefcase.
- Harness di Grok Bot. Un harness è l’ambiente che fa lavorare il modello come agente: strumenti, computer, memoria, routine. Grok 4.7 lo capisce «in modo nativo», e xAI dice che questo lo rende migliore nelle conversazioni e nel knowledge work.
- Sicurezza. Nuovo stack di safeguard, con il 3,3% di prompt rischiosi lasciati passare sul benchmark interno HackerBench v0.3.
Due numeri per capire il salto. Su GDPval, benchmark di lavoro professionale reale, Grok 4.7 al livello xhigh fa 1.695 punti Elo contro 1.605 di Grok 4.6. Su AA Briefcase v1.1, lavoro d’ufficio da più ore, passa da 1.546 a 1.657. Sono numeri del vendor: prendili come direzione, non come verdetto.
Quanto costa Grok 4.7?
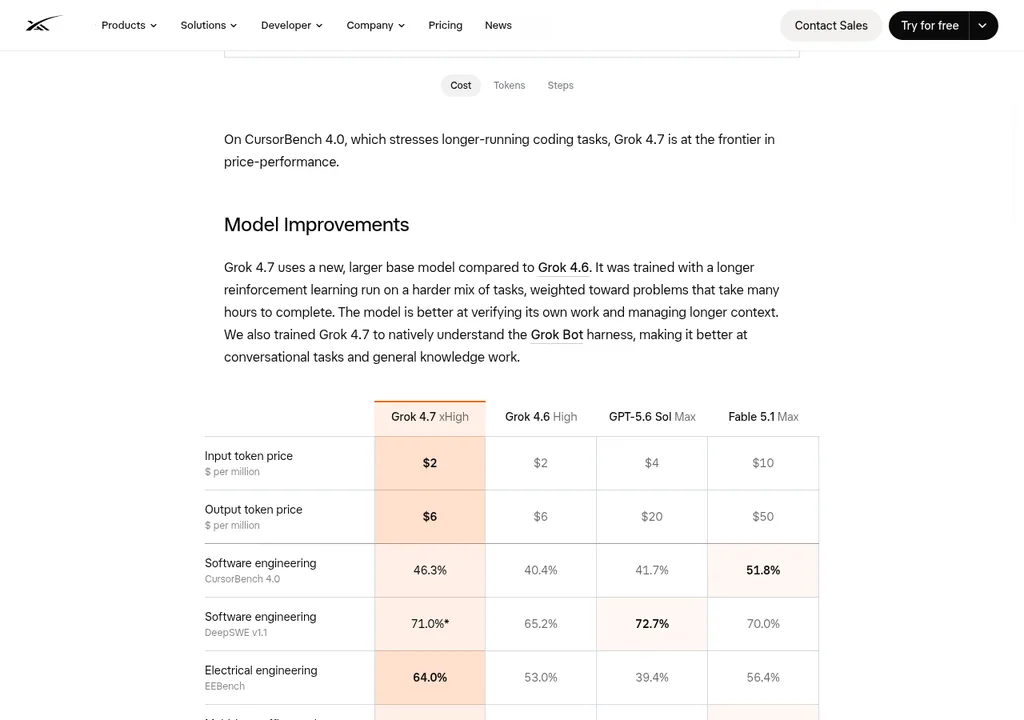
In API Grok 4.7 costa $2 per milione di token in input e $6 in output, con l’input in cache a $0,50. Sopra i 200.000 token di prompt tutta la richiesta passa a $4 / $1 / $12. Listino identico a Grok 4.6. La variante Fast costa il doppio, solo in Cursor e Grok Build.
Ho verificato il listino il 29/09/2026 sulla pagina di Grok 4.7 nella documentazione xAI e sul listino modelli della stessa documentazione. Ecco il quadro completo:
| Voce | Grok 4.7 | Grok 4.6 | Note |
|---|---|---|---|
| Input (prompt sotto 200k) | $2,00 | $2,00 | per milione di token |
| Input in cache | $0,50 | $0,50 | conviene impostare il prompt_cache_key |
| Output | $6,00 | $6,00 | per milione di token |
| Prompt da 200k in su | $4 / $1 / $12 | $4 / $1 / $12 | si applica a tutti i token della richiesta |
| Contesto | 500.000 token | 500.000 token | |
| Variante Fast | 2x il prezzo (1,5x sul lungo contesto) | anche per 4.6 in Cursor | solo Cursor e Grok Build, non in API |
| Endpoint USA | +10% | inferenza tenuta negli Stati Uniti | |
| Batch API | non supportata | niente sconto batch |
Il dettaglio che ti costa soldi se non lo sai è la soglia dei 200.000 token. Non paghi di più solo la parte che eccede: paghi tutto al prezzo doppio. Se carichi in un colpo solo un export CRM enorme o dieci PDF di competitor, spezza il lavoro in più richieste.
Altro dettaglio pratico: la documentazione xAI raccomanda di impostare un prompt_cache_key per mandare le richieste della stessa conversazione allo stesso server. Senza, scrive xAI, spesso paghi l’input pieno anche quando potresti pagare $0,50 invece di $2. Su un flusso che rilegge ogni volta le linee guida del brand, la differenza è del 75% su quella parte di prompt.
Quanto costa un brief marketing con Grok 4.7?
Un brief con 20.000 token di input (linee guida, articolo di partenza, dati) e 4.000 di output costa circa $0,064 con Grok 4.7. Lo stesso lavoro su Fable 5.1 costa circa $0,40. Il calcolo è mio, fatto sui listini ufficiali al 29/09/2026:
| Modello | Input 20k | Output 4k | Totale per brief | 100 brief al mese |
|---|---|---|---|---|
| Grok 4.7 | $0,040 | $0,024 | $0,064 | $6,40 |
| Grok 4.7 Fast (Cursor) | $0,080 | $0,048 | $0,128 | $12,80 |
| Claude Sonnet 5.5 | $0,040 | $0,040 | $0,080 | $8,00 |
| Claude Fable 5.1 | $0,200 | $0,200 | $0,400 | $40,00 |
Il conto reale dipende anche da quanti token il modello genera mentre ragiona, e con effort xhigh sono di più. Prendi questi numeri come pavimento, non come preventivo.
Quanto costa usarlo in Cursor o in Grok Build?
In Cursor non paghi a token se resti nei limiti del piano. Secondo la documentazione di Cursor su modelli e prezzi (verificata il 29/09/2026), Grok 4.7 sta nel pool «Cursor Models», che ha molto più utilizzo incluso rispetto ai modelli di terze parti. I piani individuali costano $20 (Pro), $60 (Pro Plus) e $200 al mese (Ultra); i Teams $40 a utente per lo Standard e $120 per il Premium.
Grok Build, l’agente da terminale di SpaceXAI, usa Grok 4.7 come modello di default e sulla pagina ufficiale si presenta come «Available to try for Free». La variante Fast non è inclusa nel free tier.
Dove puoi usare Grok 4.7, e Grok Bot lo usa?
Secondo xAI, Grok 4.7 è disponibile in Cursor su tutti i piani, in Grok Build come modello di default, nell’API xAI e tramite OpenRouter, Vercel e Cloudflare. Dentro Grok Bot, invece, non puoi sceglierlo: la documentazione Cursor dice che la selezione del modello la gestisce Cursor e che non c’è un selettore.
Questa è la parte che nessuno scrive chiaramente, e che cambia la domanda «devo passare Grok Bot a 4.7?». Non c’è un interruttore da girare.
- API xAI: scegli tu, con
model: "grok-4.7". Controllo totale su effort e costi. - Cursor: scegli dal selettore modelli, anche nella finestra Agents in modalità Cloud, dove l’ho usato per il mio test. Sui piani Pro e superiori puoi impostare anche l’effort e la modalità Fast.
- Grok Build: è già il default. Puoi cambiare modello con
/modelnella TUI o con-min modalità headless. - Gateway: OpenRouter, Vercel e Cloudflare, utile se il tuo stack passa già da lì.
- Grok Bot: la pagina impostazioni lo dice senza giri: «Cursor manages model selection, so there’s no model picker» (impostazioni Grok Bot, docs Cursor).
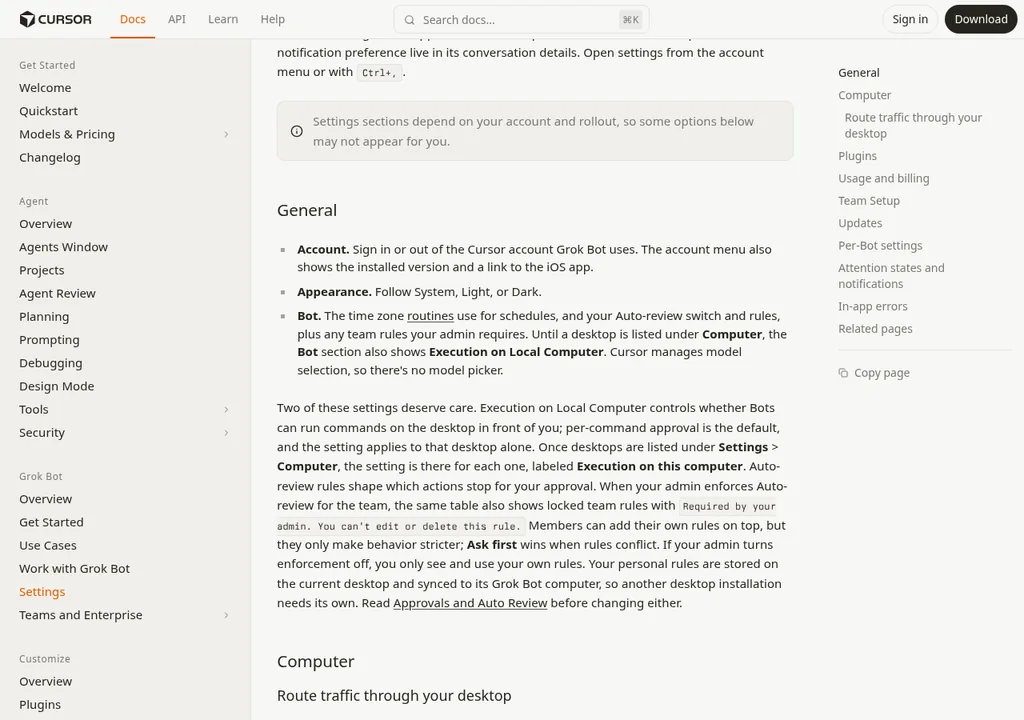
Quindi cosa significa «Grok 4.7 capisce l’harness di Grok Bot»? Che il modello è stato allenato a lavorare bene dentro quell’ambiente, con il suo computer cloud, le routine e le approvazioni. Non significa che xAI abbia dichiarato quale modello gira oggi sotto ogni Bot. Anzi: al 29/09/2026 la card dei piani Grok sulla pagina x.ai/bot elenca ancora «Grok 4.6 model» tra i vantaggi.
Il mio consiglio, se la tua redazione gira su Grok Bot: non cercare l’impostazione, non c’è. Tieni d’occhio la qualità delle routine che già usi, report, brief, research, e confrontala con le settimane scorse. Se vuoi Grok 4.7 con certezza su un flusso preciso, spostalo dove il modello lo scegli tu: Cursor, Grok Build o API. Per capire come funziona il prodotto, prezzi e setup, trovi tutto nella guida completa a Grok Bot.
E su grok.com?
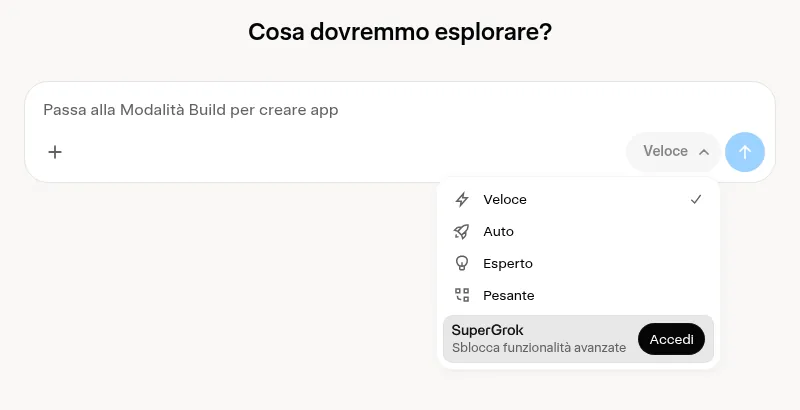
Su grok.com il selettore non mostra numeri di versione. L’ho aperto il 29/09/2026 senza login: propone le modalità Veloce, Auto, Esperto e Pesante, più l’invito a SuperGrok. L’annuncio di Grok 4.7 non cita grok.com tra i canali di lancio, quindi non ti dico quale modello c’è dietro ogni modalità.
Grok 4.7 o Fable 5.1: quale scegliere per brief, deck e copy?
Per brief, deck e research lunghe scegli Grok 4.7: sui benchmark di lavoro d’ufficio è a pochi punti da Fable 5.1 e costa da 5 a oltre 8 volte meno. Per il copy finale ad alta posta in gioco Fable 5.1 resta un candidato forte, ma i dati pubblici non misurano l’italiano: decide un test sul tuo brand.
Ecco i numeri pubblicati da SpaceXAI il 21/09/2026, con Grok 4.7 a effort xhigh, Grok 4.6 a high e Fable 5.1 a max:
| Benchmark (cosa misura) | Grok 4.7 | Grok 4.6 | Fable 5.1 | Cosa significa per te |
|---|---|---|---|---|
| Prezzo input / output | $2 / $6 | $2 / $6 | $10 / $50 | Grok costa da 5 a 8,3 volte meno |
| GDPval (lavoro professionale, Elo) | 1.695 | 1.605 | 1.735 | Fable avanti di 40 punti |
| AA Briefcase v1.1 (ufficio, multi-ora) | 1.657 | 1.546 | 1.678 | quasi pari su documenti lunghi |
| Harvey Legal Agent (lavoro legale) | 19,6% | 15,8% | 6,7% | utile per revisioni di claim e policy |
| Terminal-Bench 4.0 (terminale, multi-ora) | 37,6% | 20,3% | 57,9% | automazioni tecniche: Fable nettamente meglio |
| CursorBench 4.0 (coding lungo) | 46,3% | 40,4% | 51,8% | per script e plugin del sito vince Fable |
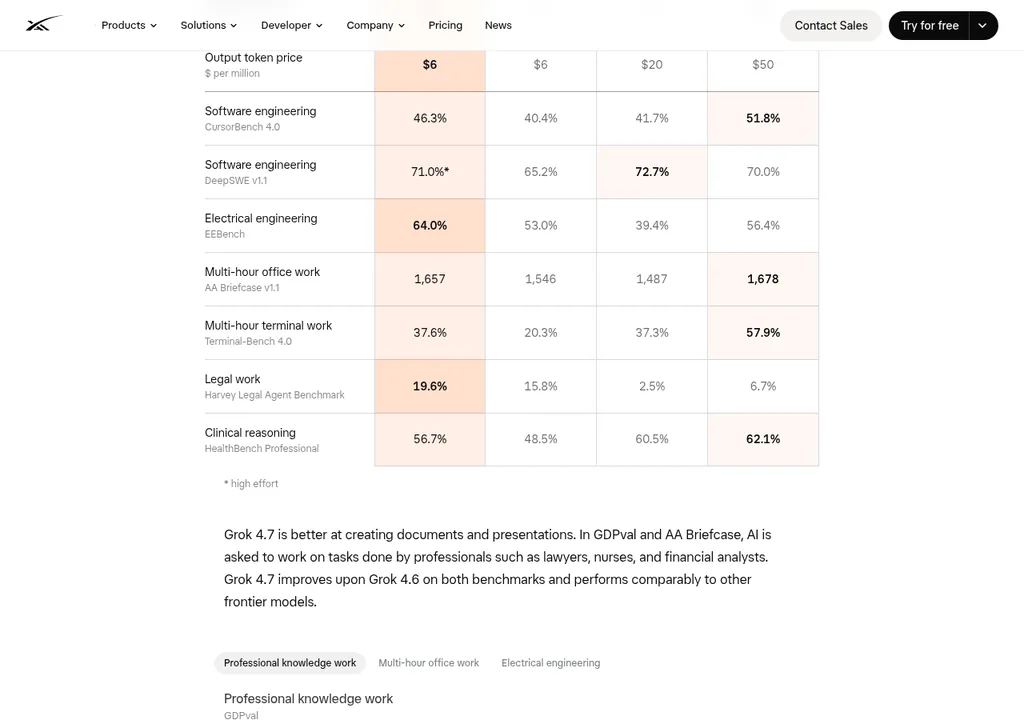
Come la leggo io. Su lavoro d’ufficio e documenti la distanza tra Grok 4.7 e Fable 5.1 è piccola: 21 punti su AA Briefcase, 40 su GDPval. Il prezzo invece è un abisso. Su un flusso che ripeti cento volte al mese, quella differenza di qualità deve valere 34 dollari al mese nel mio esempio del brief, e raramente li vale.
Dove Fable stacca davvero è il lavoro tecnico lungo, Terminal-Bench e CursorBench. Se il tuo agente deve smontare un tema WordPress o scrivere uno script di scraping, lì Fable 5.1 ha un vantaggio vero. Prezzi, punti di forza e limiti di Fable li trovi nella guida a Claude Fable 5.1.
Sul copy c’è un buco nei dati. Nessuno di questi benchmark misura headline in italiano, tono di voce o naturalezza. Se oggi usi un modello Anthropic per il copy, ricordati che Claude Sonnet 5.5 costa quasi come Grok 4.7 ($2/$10) e l’ho già testato su un task di marketing reale nella guida a Claude Sonnet 5.5.
Per quali task di marketing conviene passare a Grok 4.7?
Conviene passare a Grok 4.7 su tutti i task lunghi e strutturati che oggi fai con Grok 4.6: brief, deck, research multi-fonte, report ricorrenti. Il prezzo è identico e i benchmark di lavoro d’ufficio salgono. Resta più cauto su copy finale e task tecnici lunghi, dove Fable 5.1 ha ancora margine.
Ecco la mappa che userei, task per task:
| Task marketing | Modello consigliato | Perché |
|---|---|---|
| Brief di campagna da 5+ fonti | Grok 4.7 | lavoro lungo, costo basso, autocontrollo migliore |
| Deck per cliente o per il team | Grok 4.7 | miglioramento dichiarato su documenti e presentazioni |
| Research competitor da ore | Grok 4.7 | addestrato su compiti multi-ora, 500k di contesto |
| Report settimanale ads o SEO | Grok 4.7 | ricorrente: la differenza di costo si moltiplica |
| Revisione claim e disclaimer | Grok 4.7, poi un umano | 19,6% su Harvey Legal, ma resta un aiuto, non un legale |
| Copy finale, headline, landing | test A/B tra Grok 4.7 e il tuo modello attuale | nessun benchmark misura l’italiano |
| Script, automazioni, plugin | Fable 5.1 | Terminal-Bench 57,9% contro 37,6% |
Il passaggio in pratica, se il modello lo scegli tu:
- Scegli un flusso ripetuto, per esempio il brief settimanale del blog o il report ads del lunedì.
- Fallo girare in parallelo su Grok 4.6 e Grok 4.7 per una settimana, con lo stesso prompt e gli stessi input.
- Controlla tre cose: numeri inventati, istruzioni ignorate, tempo che ti serve per sistemare l’output.
- Imposta effort e cache: parti da high, il default, e sali a xhigh solo sui lavori da ore. Aggiungi il
prompt_cache_key. - Sposta il default a 4.7 se regge. Visto che il listino è identico, non serve che vinca di tanto: basta che non perda.
Se stai costruendo una redazione di agenti da zero, prima di scegliere il modello leggi come si divide il lavoro tra agenti nella guida agli agenti AI per il marketing. Il modello giusto su un flusso sbagliato non salva nessuno. Se cerchi un agente open source da installare oggi, la guida è OpenClaw.
Come ho messo alla prova Grok 4.7 su un task di marketing reale?
L’ho lanciato nella finestra Agents di Cursor, in modalità Cloud, con Grok 4.7 High Fast, su un lavoro vero: promuovere il mio articolo su Claude Sonnet 5.5 con un post per X, uno per LinkedIn e una meta description. Dopo i post ha ricontrollato da solo le fonti ufficiali e ha separato i fatti verificati dai claim del vendor.
Il prompt è quello che vedi nello screenshot, parola per parola. Come input gli ho dato solo l’URL di un articolo live del blog, niente testo incollato:
Sei il social media manager di victormotricala.it. Leggi questo articolo: https://www.victormotricala.it/ai/claude-sonnet-5-5 Scrivi: 1) un post per X sotto i 280 caratteri; 2) un post LinkedIn da 120-180 parole; 3) una meta description tra 150 e 160 caratteri. Per ognuno indica il numero esatto di caratteri (o di parole per LinkedIn). Usa solo numeri presenti nell’articolo e segnala qualsiasi claim che non riesci a verificare.
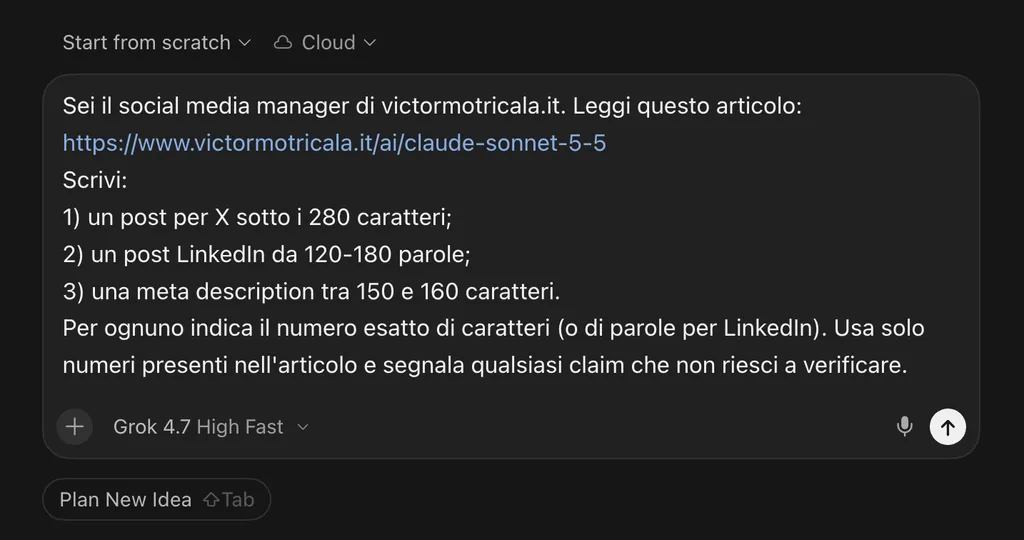
Il selettore c’è ed è quello della finestra Agents di Cursor: Grok 4.7 si sceglie dal menu, e l’etichetta «High Fast» indica effort alto e variante Fast. Non confonderlo con Grok Bot, dove il selettore non esiste, come ho scritto sopra. Questo test ti dice come si comporta Grok 4.7 in Cursor, non quale modello gira dentro il tuo Bot.
Cosa ho guardato per giudicare l’output:
- Numeri: prezzi, date e punteggi uguali a quelli dell’articolo.
- Istruzioni: se ha davvero segnalato i claim che non poteva verificare.
- Invenzioni: dati o promesse che nella pagina non ci sono.
- Effetti collaterali: cosa fa l’agente oltre a rispondere.
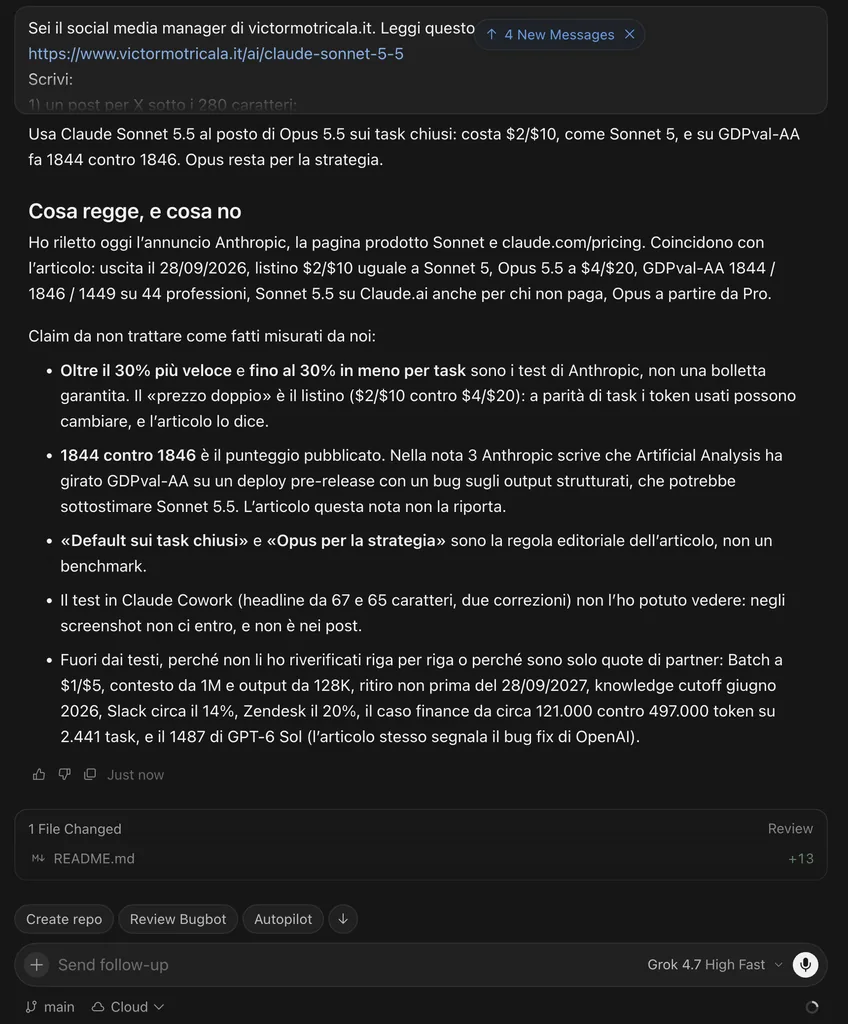
L’ho testato: cosa è andato e cosa no
È andato a controllare le fonti da solo. Gli avevo dato solo l’URL del mio articolo. Nella sezione «Cosa regge, e cosa no» scrive di aver riletto l’annuncio Anthropic, la pagina prodotto di Sonnet e claude.com/pricing, e conferma uscita il 28/09/2026, listino $2/$10, Opus 5.5 a $4/$20 e i punteggi GDPval-AA 1844, 1846 e 1449. Nessuno gli aveva chiesto di uscire dalla mia pagina.
Ha separato fatti, claim del vendor e scelte editoriali. Sotto il titolo «Claim da non trattare come fatti misurati da noi» mette in fila cose di natura diversa. Il «30% più veloce» è un test di Anthropic, non una bolletta garantita. La regola «default sui task chiusi, Opus per la strategia» è editoriale, non un benchmark, e ha ragione. Poi c’è un elenco di dati che dichiara di non aver ricontrollato riga per riga. L’istruzione «segnala qualsiasi claim che non riesci a verificare» l’ha presa alla lettera.
Mi ha trovato un buco. Fa notare che nella nota 3 dell’annuncio Anthropic scrive che Artificial Analysis ha fatto girare GDPval-AA su un deploy pre-release con un bug sugli output strutturati, e che il mio articolo non lo riporta. Ho controllato sulla pagina di Anthropic: la nota c’è, e nel mio pezzo manca. La conclusione non cambia, perché Anthropic si aspetta un effetto piccolo e semmai a svantaggio di Sonnet 5.5. Ma è il dettaglio che separa un fact-check vero da una parafrasi.
Ha ammesso quello che non vedeva. Il mio test in Claude Cowork, con le headline da 67 e 65 caratteri, sta negli screenshot dell’articolo. Grok 4.7 lo dice chiaro: non l’ha potuto vedere, quindi non lo tratta come verificato. Preferisco mille volte questo a un giudizio inventato.
Ha modificato un file che nessuno aveva chiesto. In fondo alla risposta Cursor mostra «1 File Changed»: README.md, +13 righe. In modalità Cloud Grok 4.7 non si limita a chattare, lavora come agente dentro un repository, sul branch main. È un punto pratico: se lo usi per il copy, lavora in un repo di prova e guarda le modifiche prima di accettarle.
Cosa non posso dirti. I post per X e LinkedIn e la meta description sono arrivati prima del controllo, nella parte della risposta che nello screenshot è fuori schermo. Non ti do quindi un giudizio sulla qualità del copy e non riconto numeri che non vedo. Non ho cronometrato il tempo di risposta e non ho rilanciato lo stesso prompt su Grok 4.6 per un confronto diretto.
Il mio verdetto: in Cursor Grok 4.7 è un fact-checker molto solido. Esegue l’istruzione «segnala i claim» con rigore, distingue da solo tra dato verificato, dato del vendor e opinione, e mi ha trovato una nota che avevo saltato. Tre cose da portarti a casa:
- scrivi sempre nel prompt «segnala i claim che non riesci a verificare»: con Grok 4.7 non è decorazione, la esegue sul serio;
- usalo come secondo lettore dei tuoi articoli prima di pubblicarli, non solo per scrivere i post che li promuovono;
- in modalità Cloud ricordati che è un agente: può creare o modificare file nel repo, quindi controlla la lista delle modifiche prima di approvarle.
E ho verificato oggi le fonti ufficiali di questo articolo: annuncio SpaceXAI, documentazione xAI e docs Cursor. I prezzi e i numeri che leggi qui vengono da lì, con la data accanto.
Quali sono i limiti di Grok 4.7?
I limiti principali sono cinque: benchmark tutti pubblicati dal vendor, prezzo doppio sopra i 200.000 token di prompt, nessuna Batch API, knowledge cutoff a maggio 2026 e nessun controllo sul modello dentro Grok Bot. In più, nessun dato pubblico misura la qualità della scrittura in italiano.
Vediamoli uno per uno, perché ognuno ha una contromossa:
- Benchmark del vendor. Tutti i numeri di questo articolo vengono da SpaceXAI, e confrontano Grok 4.7 a xhigh con i rivali a max o high. Contromossa: il tuo test su un flusso vero.
- La soglia dei 200k. Superata, paghi il doppio su tutta la richiesta. Contromossa: spezza gli input grandi.
- Niente Batch API. Per i lavori notturni in blocco non c’è lo sconto batch. Contromossa: cache e prompt più corti.
- Cutoff maggio 2026. Senza gli strumenti di ricerca attivi non sa nulla dopo quella data. Contromossa: attiva web search e X search in API, o dagli tu le fonti.
- Grok Bot non si configura. Non scegli il modello e non sai quale gira. Contromossa: misura l’output, non l’etichetta.
- Fast solo in Cursor e Grok Build. Se ti serve velocità in API, oggi non la compri.
Un’ultima nota sulla velocità. L’annuncio parla di Grok 4.7 «twice as fast» rispetto ai modelli comparabili, ma nella stessa pagina dice anche che è servito alla stessa velocità di Grok 4.6. Rispetto a 4.6, quindi, non aspettarti un salto di velocità: il guadagno è nella qualità a parità di costo.
Quali sono le domande più frequenti su Grok 4.7?
Grok 4.7 è gratis?
In API no: costa $2 per milione di token in input e $6 in output. SpaceXAI presenta Grok Build, dove Grok 4.7 è il default, come «available to try for free», senza la variante Fast. In Cursor, secondo xAI, è disponibile su tutti i piani, con limiti diversi.
Il prezzo di Grok 4.7 è uguale a Grok 4.6?
Sì. Stesso listino API: $2 input, $0,50 input in cache, $6 output per milione di token sotto i 200.000 token di prompt, e $4 / $1 / $12 sopra. Anche in Cursor le due versioni hanno la stessa tariffa, verificata il 29/09/2026.
Su Grok Bot conviene passare subito a Grok 4.7?
Non puoi farlo tu: la documentazione di Cursor dice che la selezione del modello in Grok Bot è gestita da Cursor e che non c’è un selettore. Se vuoi Grok 4.7 con certezza su un flusso, spostalo in Cursor, Grok Build o API.
Grok 4.7 è meglio di Fable 5.1?
Dipende dal task. Sui benchmark di lavoro d’ufficio Fable 5.1 è avanti di poco (1.678 contro 1.657 su AA Briefcase), sul lavoro tecnico lungo di molto. Ma Fable costa $10/$50 contro $2/$6: per brief e deck ripetuti Grok 4.7 ti dà di più per ogni euro.
Qual è il contesto massimo di Grok 4.7?
La finestra di contesto è di 500.000 token, con output di testo senza limite dichiarato e knowledge cutoff a maggio 2026. Oltre i 200.000 token di prompt la richiesta costa il doppio, quindi il contesto lungo usalo solo quando serve davvero.
Allora, conviene passare a Grok 4.7?
Sì, ovunque il modello lo scelga tu. Grok 4.7 costa esattamente come Grok 4.6, lavora meglio su documenti, deck e compiti lunghi e tiene 500.000 token di contesto. Restare su 4.6 in API, Cursor o Grok Build non ha senso economico. Dentro Grok Bot, invece, la scelta non è tua: misura le routine che già usi.
Il confronto vero è con Fable 5.1: sui documenti è quasi pari, sul lavoro tecnico lungo vince Fable, che costa da 5 a 8 volte di più. Il mio consiglio: questa settimana fai girare un flusso ripetuto, il brief del lunedì o il report ads, su Grok 4.7 accanto al modello che usi oggi. Se regge, spostalo a default. E provalo anche come fact-checker: nel mio test in Cursor è la cosa che ha fatto meglio.
Per il quadro completo dei modelli che usiamo nel marketing, parti dalla guida completa all’intelligenza artificiale.
Autore: Victor Motricala, growth hacker e consulente di marketing e AI. Su victormotricala.it scrivo playbook operativi per marketer italiani, testando gli strumenti sul lavoro vero.
